09/10/2026Il caso Limite: il modello italiano che fa matematica meglio dei giganti
Da un po' di tempo, qui su Commit, abbiamo quasi smesso di raccontare ogni modello che esce.
A parte i rilasci veramente grossi o importanti, il ritmo è diventato ingestibile, e l'ennesimo "+2% su un benchmark" non aiuta nessuno a capire dove stiamo andando.
Questa settimana facciamo un'eccezione. Perché è uscito un modello che merita di essere raccontato, e arriva da Roma.
Chi c'è dietro
Paradigma è una startup romana fondata da Francesco Pappone, Giulio Starace (ex ricercatore OpenAI) ed Emanuele Rodolà (professore alla Sapienza).
La missione è ambiziosa senza mezzi termini: automatizzare la ricerca scientifica, dalle ipotesi alla validazione.
Non sono gli unici a crederci: sono l'unica realtà italiana tra le dieci finaliste della Next Frontier AI Challenge, il programma tedesco da 125 milioni di euro nato per ridurre il distacco dell'Europa dall'AI di frontiera americana.
E dopo poche settimane di lavoro hanno rilasciato il loro primo modello: Limite 1B - Violetto.
Ok, ma cos'è Limite?
Anche se non è il primo modello addestrato in Italia da zero - l’LLM Minerva di Sapienza NLP e Italia di iGenius, entrambi del 2024, lo hanno preceduto - è il primo modello italiano competitivo con lo stato dell'arte su un asse di capacità difficile.
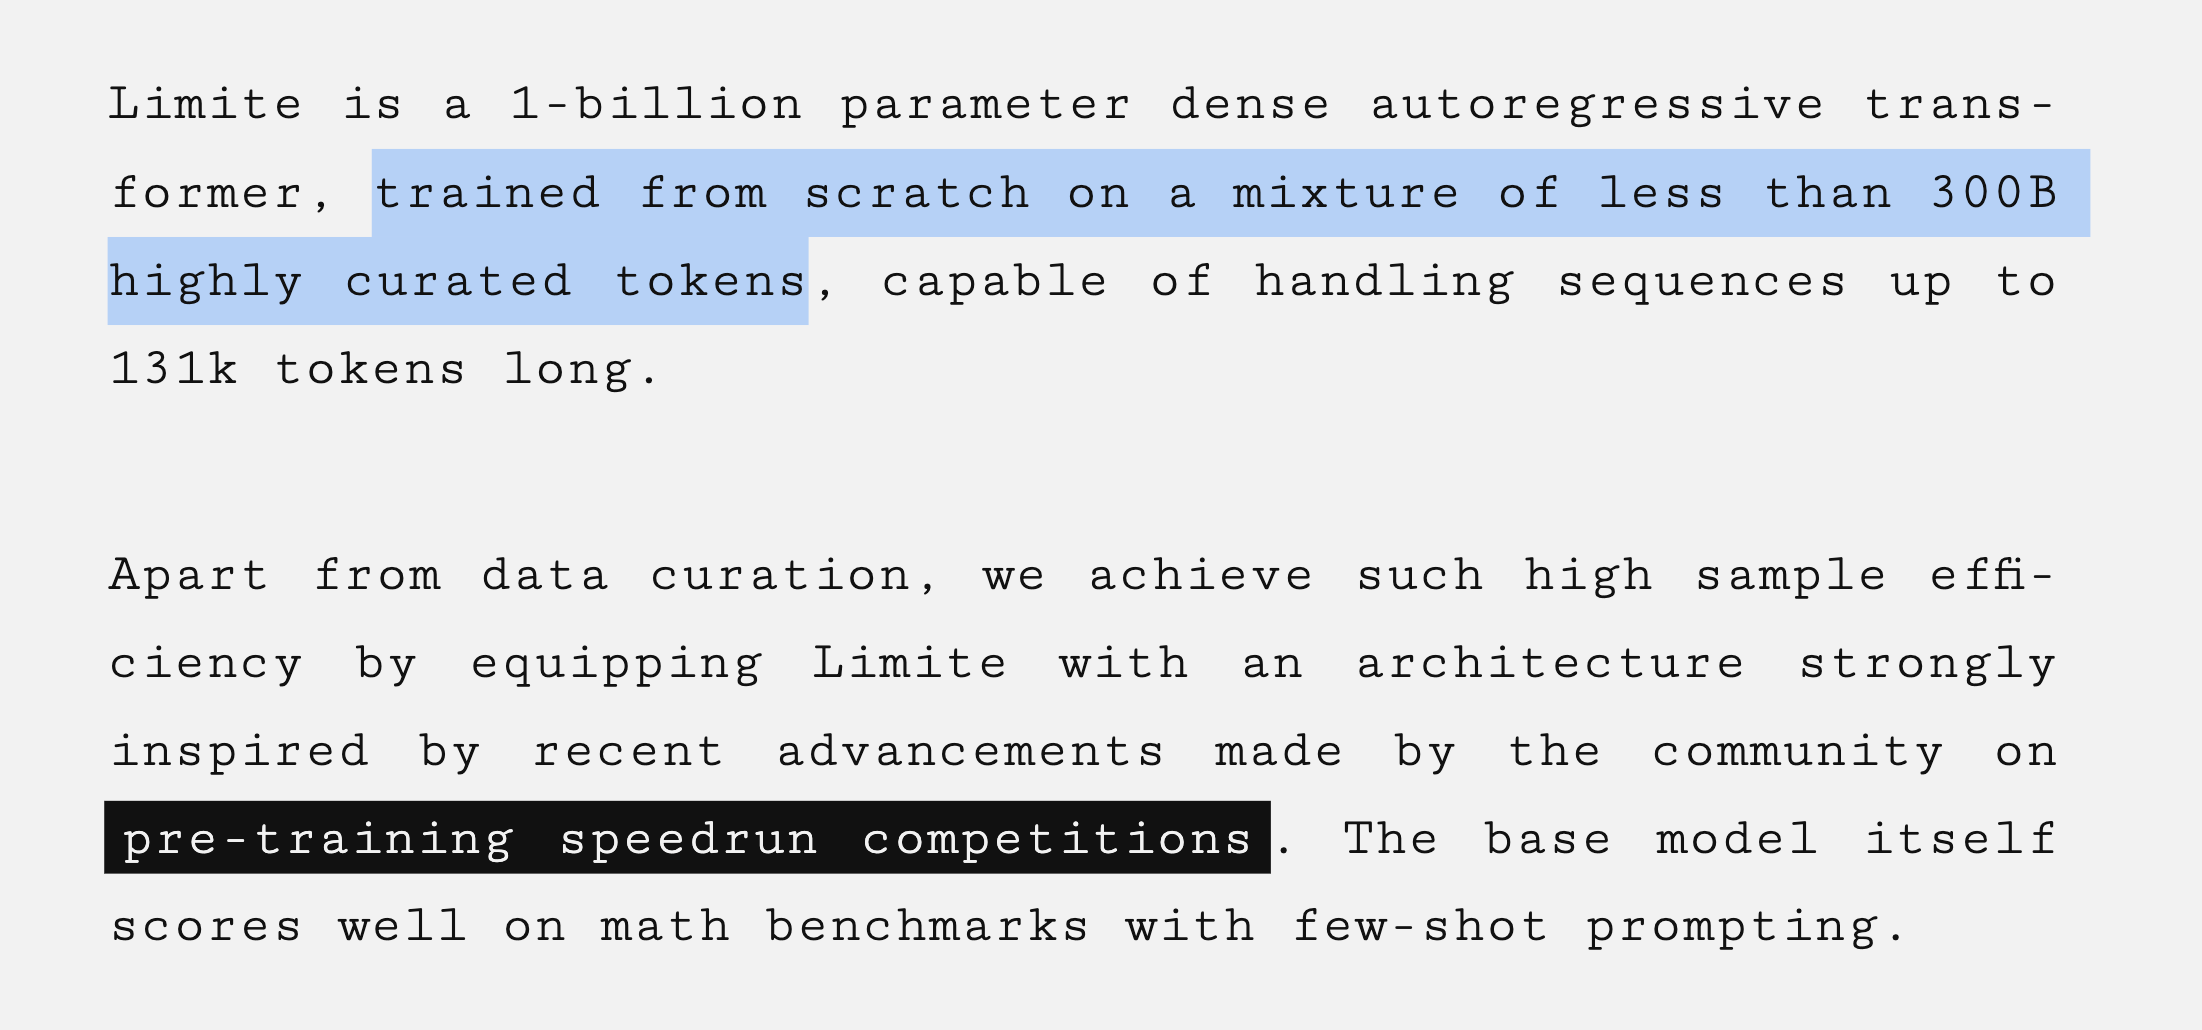
Limite, infatti, è un modello da 1 miliardo di parametri, addestrato da zero in sole 6 settimane su meno di 300B token scelti e costruiti apposta, con un unico obiettivo: ragionare su problemi matematici difficili, in modo estremamente efficiente.
Il risultato?
E, con un contesto fino a 131k token, pare riuscirci meglio di modelli trenta volte più grossi.
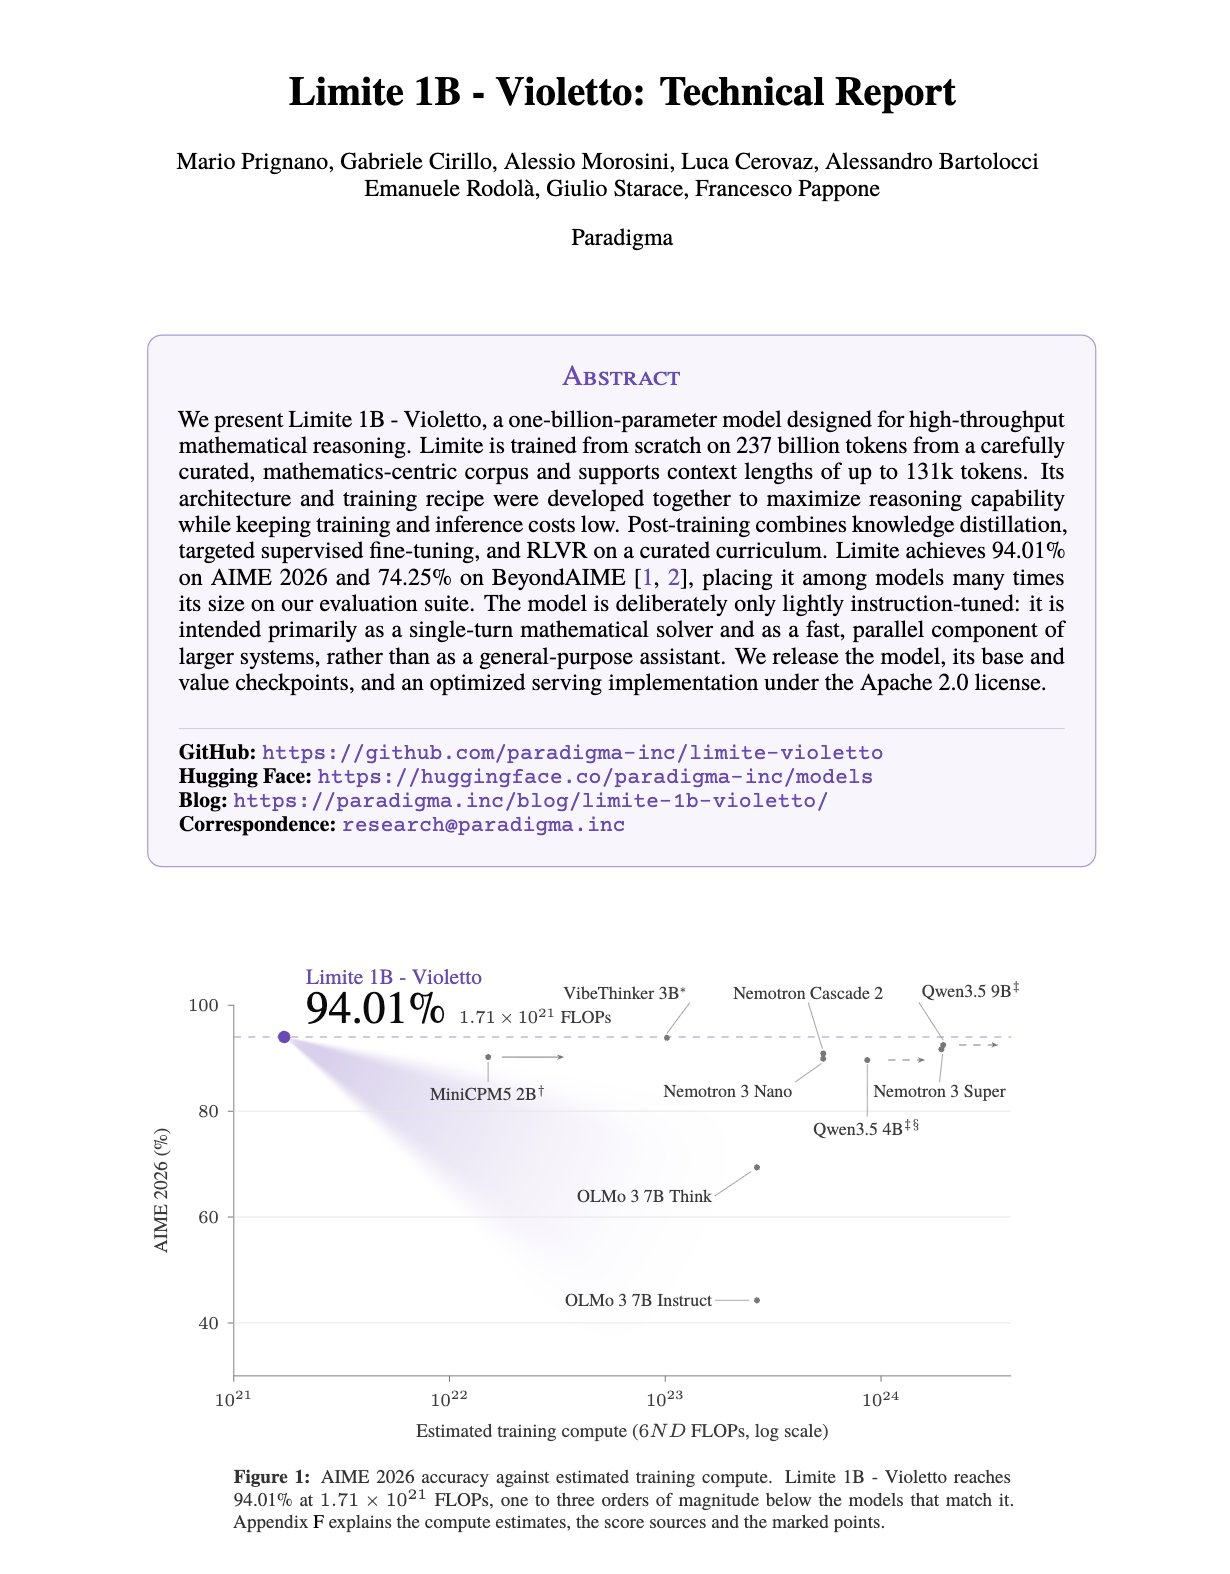
Fa il 94% su AIME 2026, il punto di riferimento per la matematica competitiva, con un compute di training da 10 a 1000 volte inferiore ai modelli che ottengono punteggi simili (Nemotron, Qwen3.5 9B e compagnia).
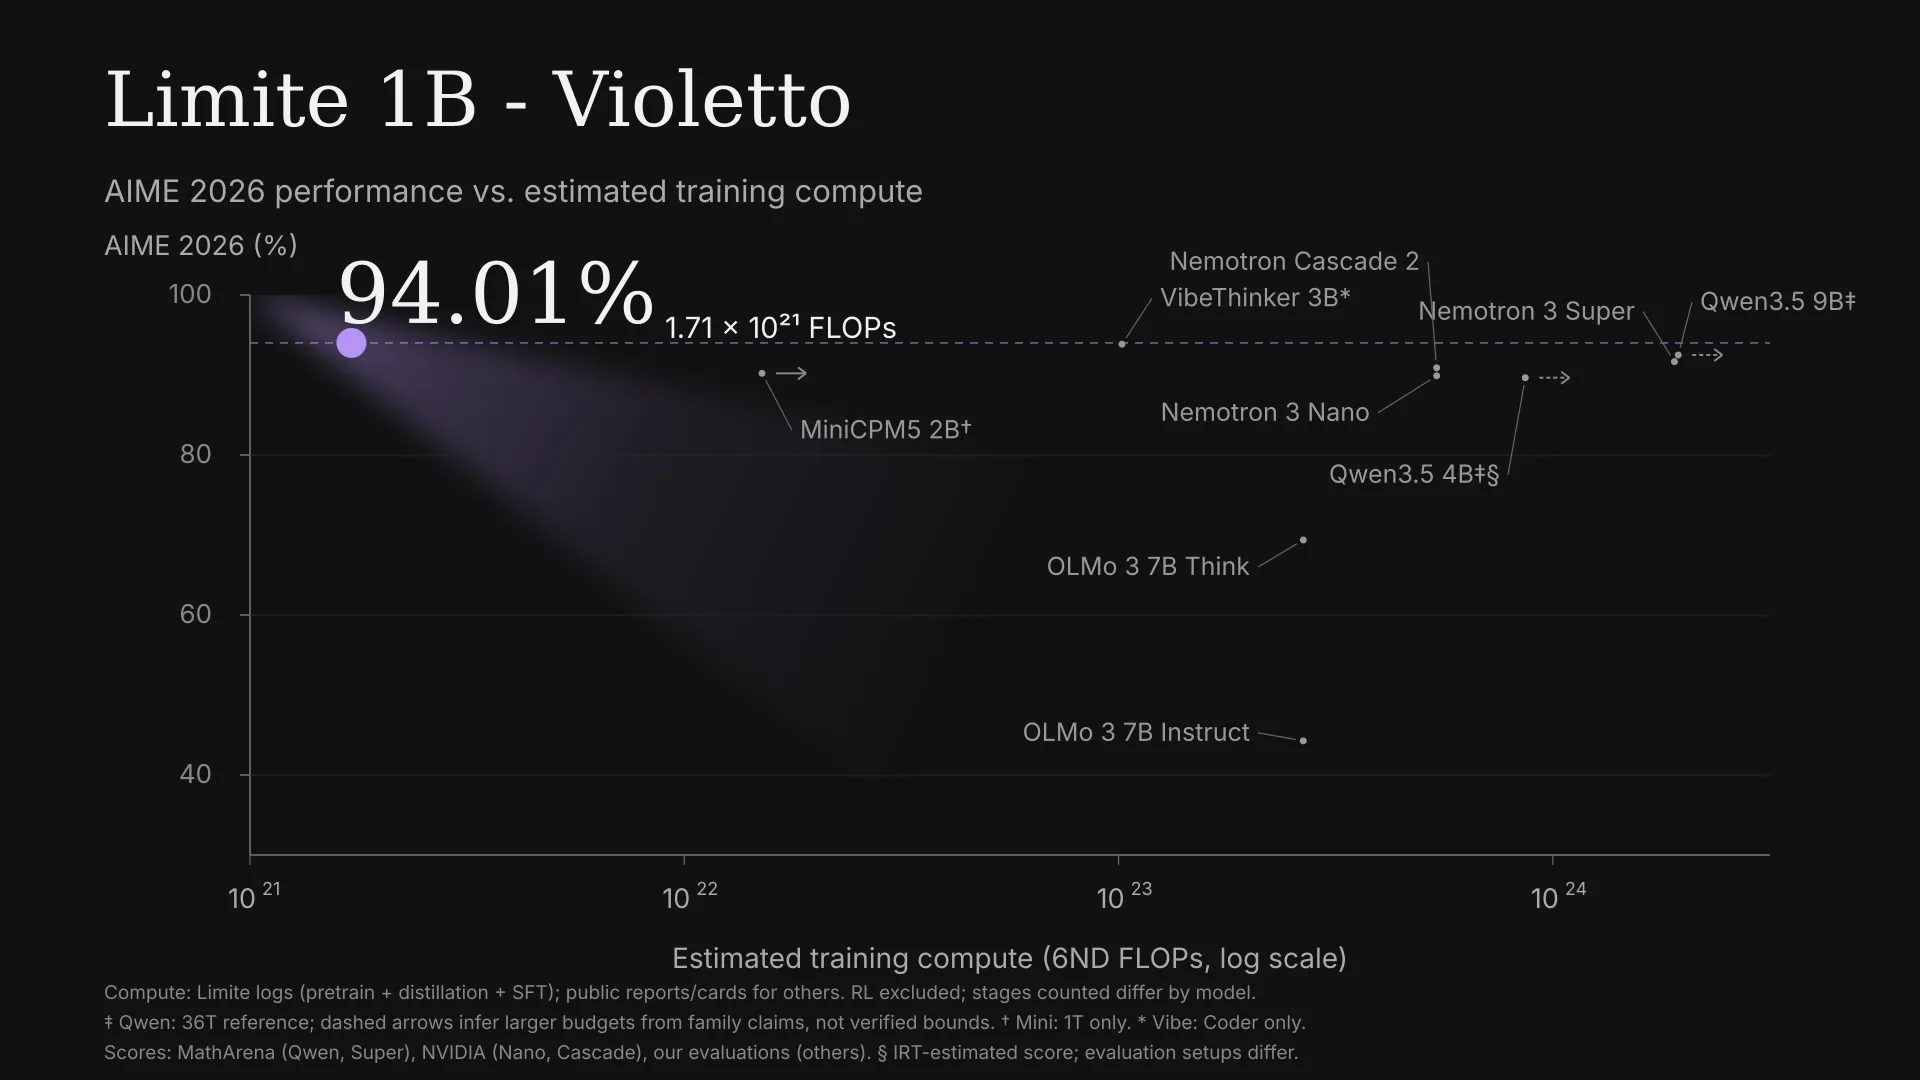
E ottiene addirittura il 74,25% su BeyondAIME, la versione più difficile, contro il 70% di un modello da 30B.
Il segreto dichiarato sono tre ingredienti:
- data curation maniacale
- un'architettura ispirata alle pre-training speedrun competitions (quelle gare della community in cui si cerca di addestrare un modello decente nel minor tempo possibile)
- e un post-training che mescola dati sintetici, Supervised Fine Tuning e Reinforcement Learning.
Insieme al modello rilasciano le evaluation, il value model usato in training e un plugin per vLLM per servirlo in modo efficiente. Tutto tutto open, su Hugging Face e GitHub.
Attenzione, però…
Limite non è un chatbot e anzi è volutamente poco incline a seguire le istruzioni.
Paradigma vuole mettere in discussione l'idea che un modello debba interpretare l'assistente personale per funzionare bene.
Niente persona gentile, niente "Ottima domanda!", solo ragionamento matematico a raffica.
- Se gli chiedi cos'è la fotosintesi, ti risponde parlando di divisione cellulare e di serie geometriche.
- Se gli chiedi cosa causa le stagioni, tira fuori il ciclo di 400 anni del calendario gregoriano.
- Se gli chiedi la differenza tra metafora e affermazione letterale, ti parla di morfismi.
È il collega brillantissimo che tratta ogni problema come un problema matematico
Giudicarlo come un assistente sarebbe come lamentarsi che un microscopio non fa le telefonate: Limite è un componente pensato per sistemi che fanno ricerca in modo autonomo.
Nel frattempo, però, davanti a un problema combinatorio su una scacchiera 2025×2025 trova la struttura giusta, riduce tutto al totiente di Eulero e chiude con 1080.
Elegante, senza forza bruta.
Anche qui, però, qualche cautela:
- alcuni numeri dei modelli di confronto sono presi da model card e MathArena, non rilanciati dal team
- e la matematica da competizione, per quanto difficile, ha una natura particolare: problemi ben posti, risposta unica, verificabile.
È esattamente il terreno dove RL e dati sintetici danno il massimo.
Il salto verso la "ricerca scientifica autonoma" che Paradigma dichiara come obiettivo è un altro sport, dove spesso il problema difficile è capire quale sia la domanda giusta.
Ma la direzione è quella giusta.
Perché ne parliamo?
Per noi Limite è una delle release più interessanti dell'anno, soprattutto per quello che dimostra sul metodo: un team piccolo, sei settimane, pochi token scelti bene, e un risultato che costringe a rivedere qualche assunto sulla scala.
Che dentro ci sia tanta competenza italiana è una dolcissima ciliegina.
Anche perché, finora, quando si parlava di AI "di frontiera", l'Italia stava in tribuna. Commentavamo i modelli di OpenAI, Anthropic, DeepSeek, Qwen. Al massimo li adattavamo.
Per la community "frontier" indica i modelli più capaci in assoluto, e un 1B specializzato non lo è.
Ma, con Limite, un team italiano si siede al tavolo dove si gioca davvero, sul terreno più difficile che c'è (il ragionamento matematico) e con la carta su cui i giganti sono più deboli: l'efficienza.
L’arte di fare di più con meno è esattamente la sfida che un laboratorio europeo, senza i budget della Silicon Valley, può e deve vincere.
Perché l'innovazione nell'AI non deve per forza arrivare solo da San Francisco o da Hangzhou. Può arrivare anche da qui 🍕
Il punto, per noi, va oltre il modello.
- La scala non è l'unica leva.
Da anni il dibattito è dominato dall'equazione "più parametri, più compute, più capacità". Limite è l'ennesima prova che su un dominio stretto, con dati puliti e un training ben progettato, l'efficienza per parametro può fare cose che sembravano riservate ai giganti. E un modello da 1B lo fai girare anche senza un data center alle spalle. - Il ragionamento senza persona è un esperimento che vale la pena fare.
Se una parte della capacità dei modelli viene sacrificata per renderli piacevoli da usare, capire quanto costa quella maschera è una domanda scientifica seria. E lo abbiamo visto di recente anche con Jev e i System One Models.
Un progetto come questo funziona da calamita: attira talenti che altrimenti partirebbero, capitali che altrimenti andrebbero altrove, attenzione internazionale su un paese che nell'AI viene raramente nominato.
Dopo un paio d'anni in cui l'AI italiana ha fatto parlare di sé più per gli annunci che per i risultati, finalmente c'è qualcosa di misurabile, aperto e verificabile di cui essere orgogliosi.
La ricetta è meno misteriosa di quanto sembri: trovi persone eccezionali, gli dai spazio, capitale e risorse, e le lasci lavorare.
L'ecosistema italiano è ancora quasi tutto da costruire, ma è proprio questo che lo rende interessante.
Non lo useremo per farci spiegare le stagioni, questo è certo.
Ma se i prossimi training run, che loro stessi definiscono molto più ambiziosi, mantengono questa efficienza, la domanda "quanto deve essere grande un modello per ragionare bene?" potrebbe avere una risposta molto più piccola di quella che ci aspettavamo.
Giacomo Ciarlini - CIO - Datapizza
Simone Conversano - AI Transformation & Marketing Specialist - Datapizza