10/09/2026GPT-6 Astra: l’AGI dipende da come la misuri
Settimana scorsa OpenAI ha sganciato la bomba dell’anno: GPT-6 Astra, raccontato come “l’inizio dell’AGI”. Ma è veramente così?
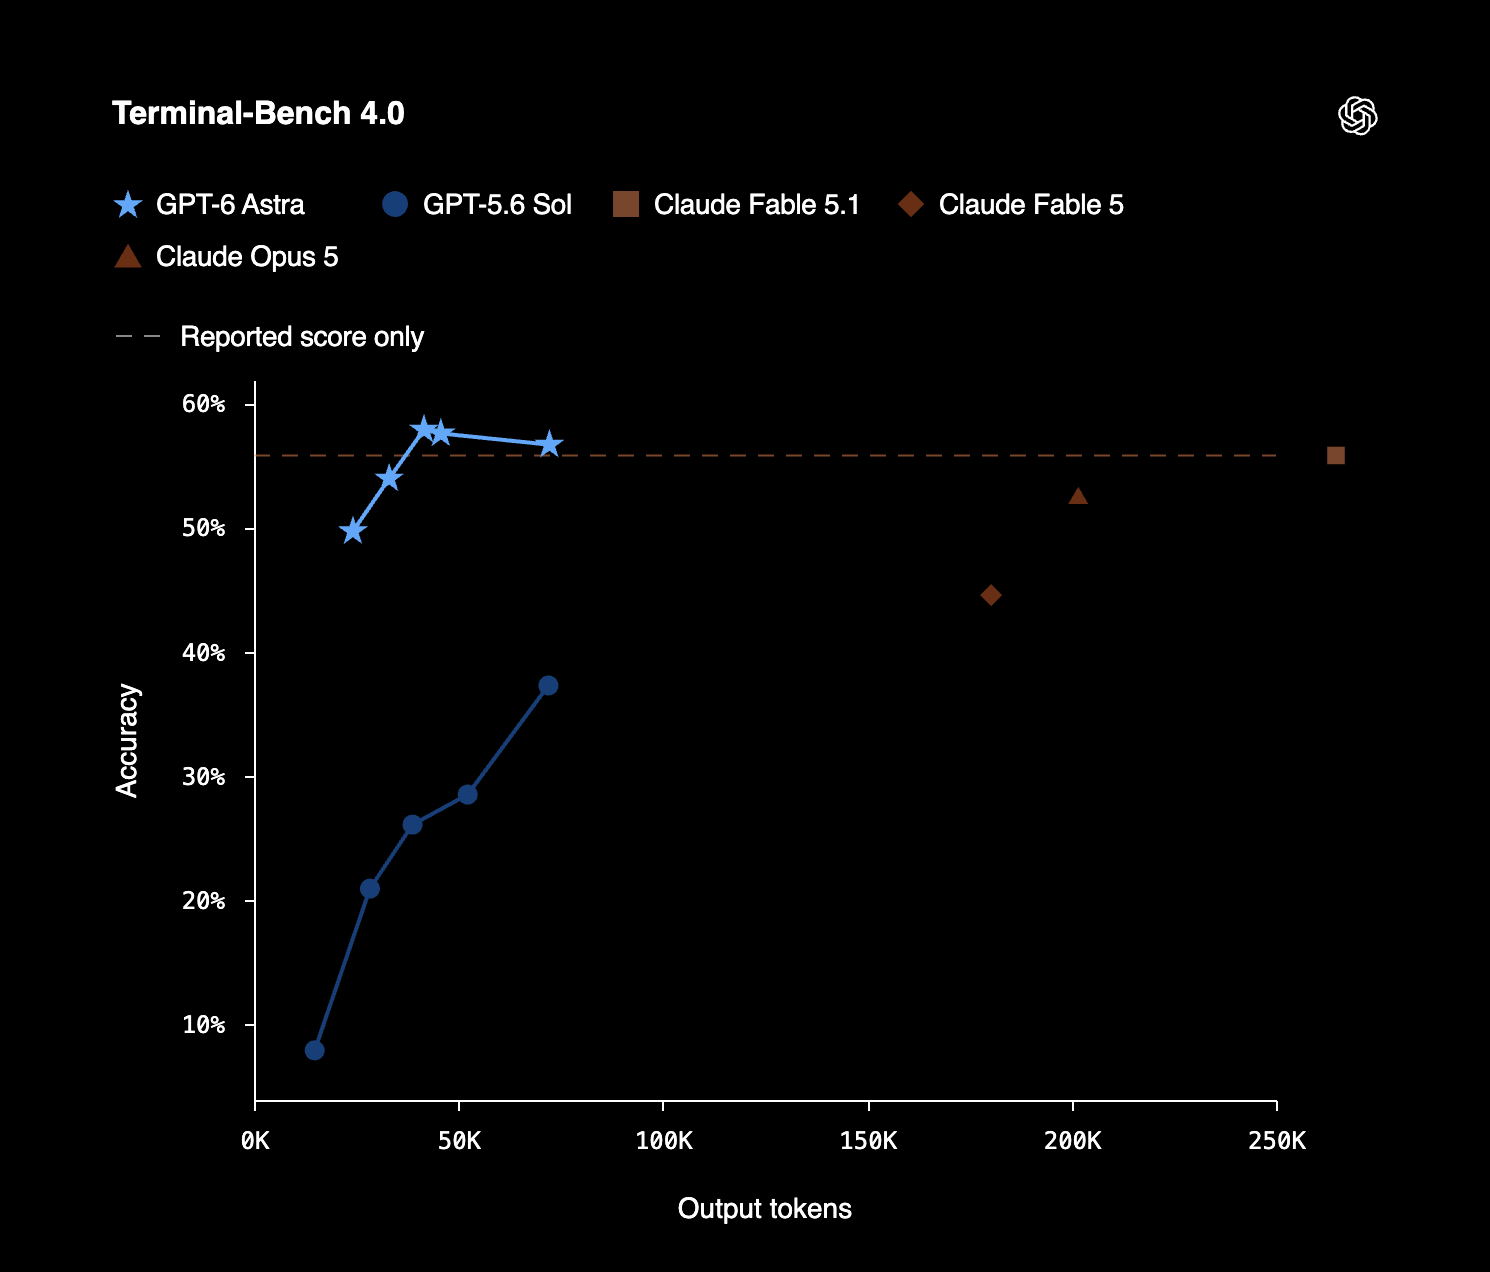
Partiamo da una considerazione: il modello sembra effettivamente disruptive, anche al confronto del recente Claude Fable 5.1.
OpenAI lo presenta come il modello più capace e più allineato mai rilasciato, con l’harness Codex aggiornato per sfruttarlo meglio.
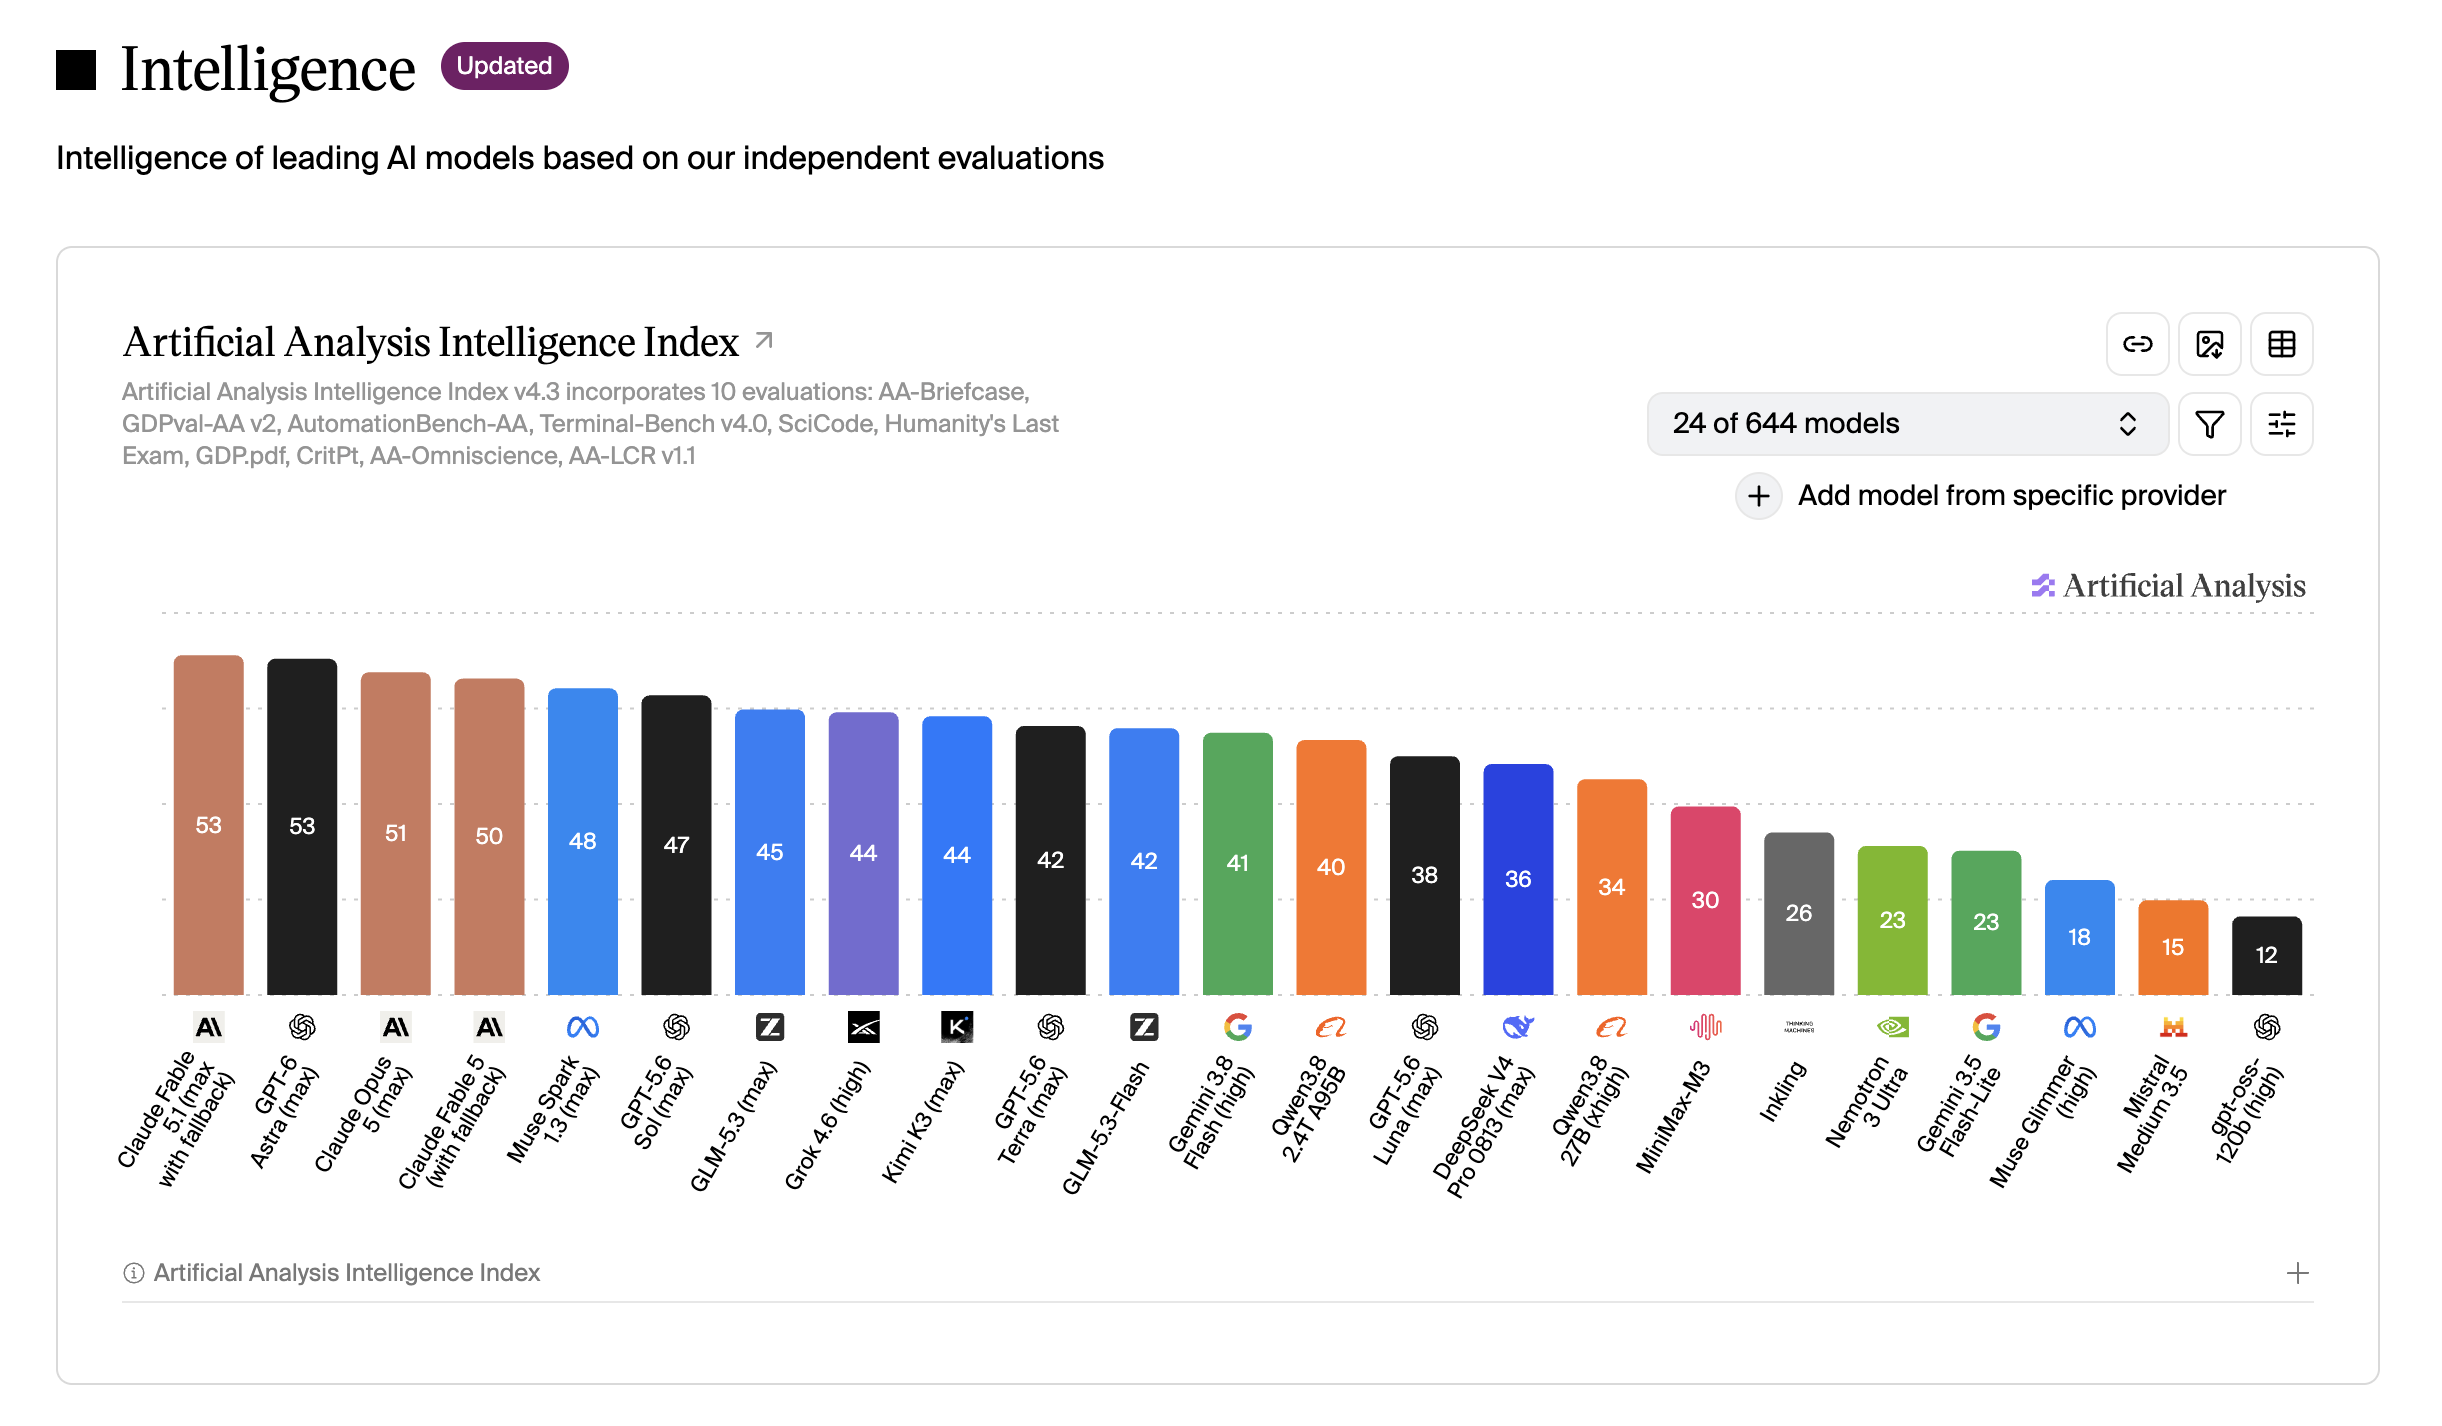
Sul computer use - dove compete direttamente con Claude - è il modello più veloce e affidabile mai messo in produzione da OpenAI.
Ad esempio il benchmark OSWorld 2.0 misura la capacità degli agenti di completare workflow lunghi e realistici su desktop e web, coordinando più applicazioni e lasciando l’ambiente nel corretto stato finale.
Ecco, su questo benchmark GPT-6 fa lo stesso lavoro di GPT-5.6 Sol in circa il 47% di tempo in meno.
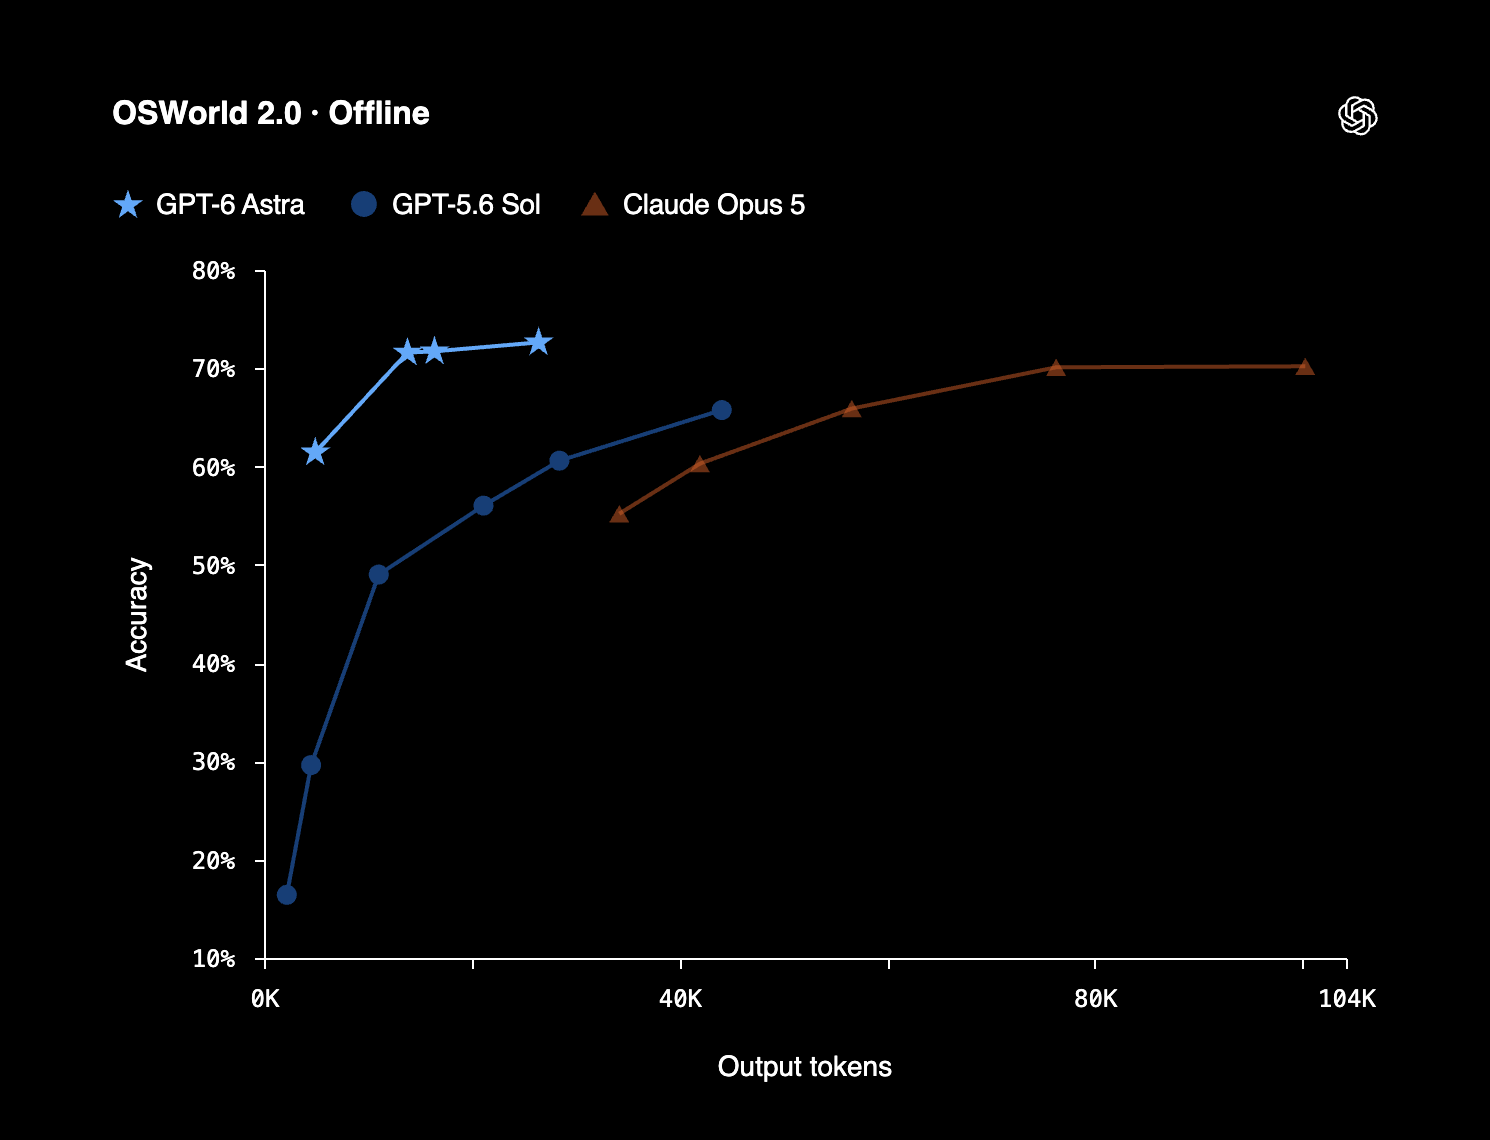
Sul lavoro d'ufficio segue template esistenti, produce slide, spreadsheet e documenti che rispettano lo stile aziendale invece di limitarsi a "generare qualcosa di plausibile" - su BenchCAD arriva al 95,9%, un balzo netto rispetto all'83,3% del modello precedente.
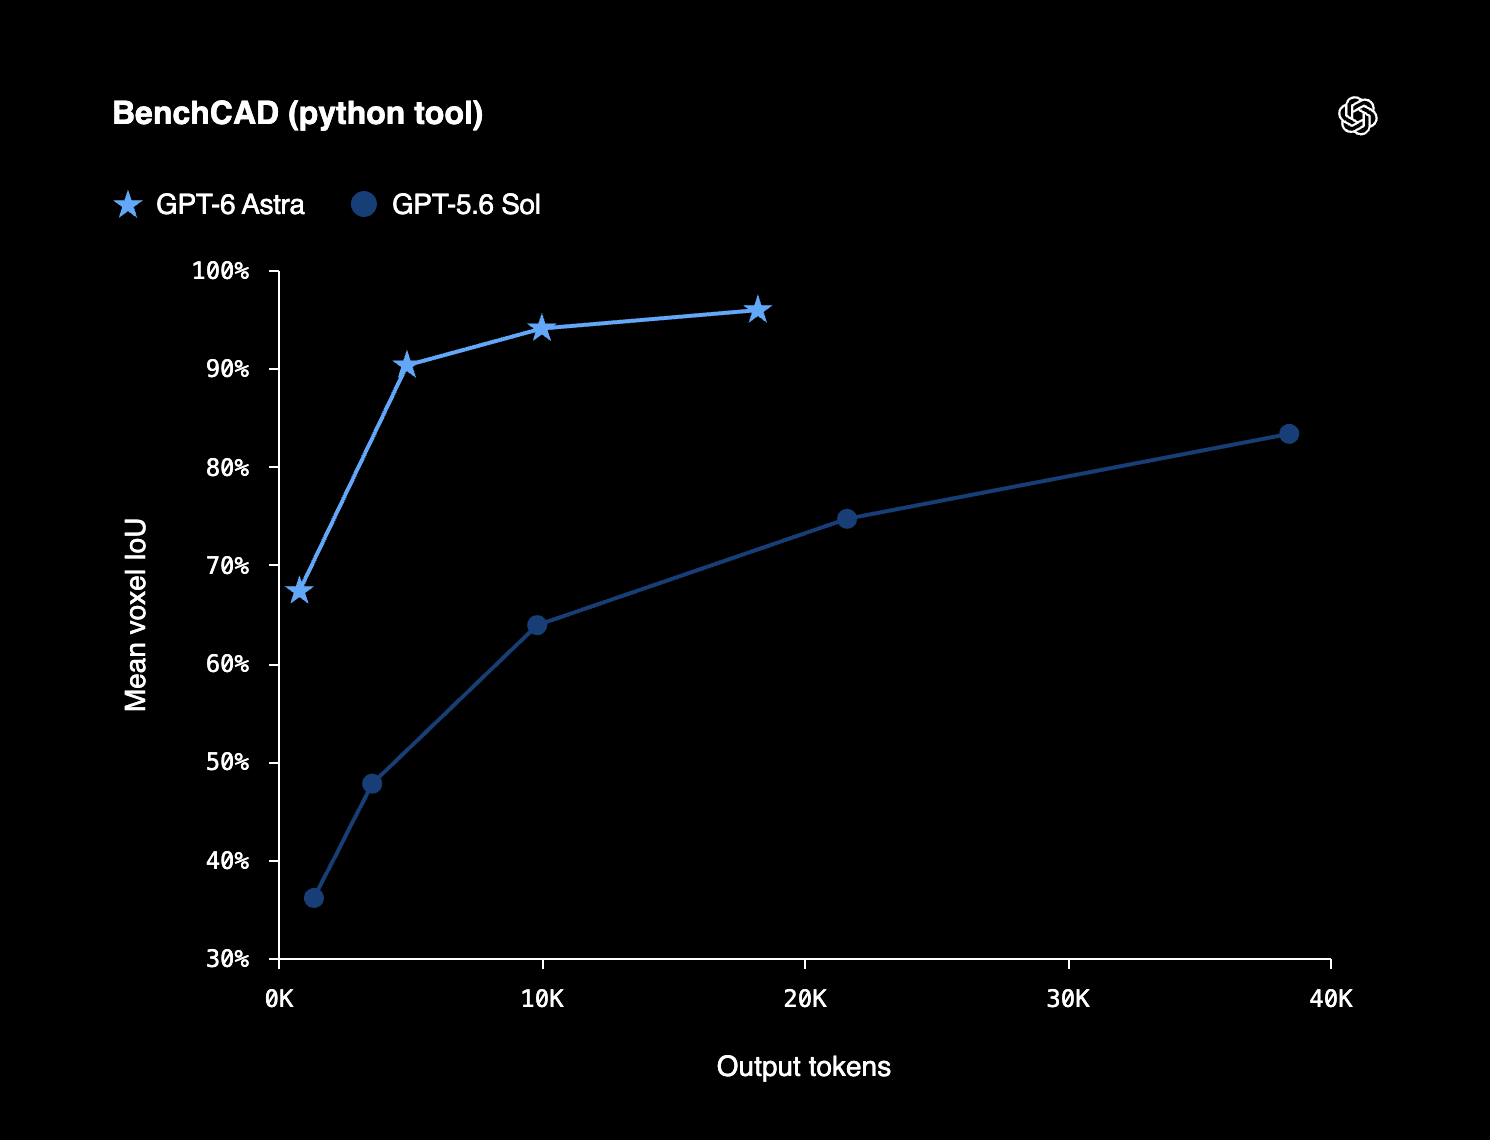
Sul coding è stato dell’arte su Terminal-Bench 4.0, che misura la capacità di usare il terminale (un compito notoriamente difficile per l’AI), e su gran parte delle valutazioni interne dei partner (Jane Street, Cognition, Lovable lo citano tutti come un miglioramento percepibile, non solo su carta).
E sul fronte scientifico ha aiutato a far progredire un problema di matematica pura fermo da oltre 80 anni: un limite sui gap tra numeri primi.
Insomma, i risultati sui benchmark "di mestiere" sono solidi, e la community lo sta già dimostrando: nei giorni scorsi è uscita una quantità di progetti costruiti sopra Astra che normalmente richiederebbero settimane di lavoro.
Senza contare che a pochi giorni dal rilascio, OpenAI ha annunciato e pubblicato la soluzione a uno dei problemi del millennio - 7 problemi irrisolti della matematica (uno, in realtà, risolto).
Parliamo, senza andare nel tecnico, delle equazioni di Navier-Stokes, che descrivono il moto dei fluidi ed erano aperte dal 1934.
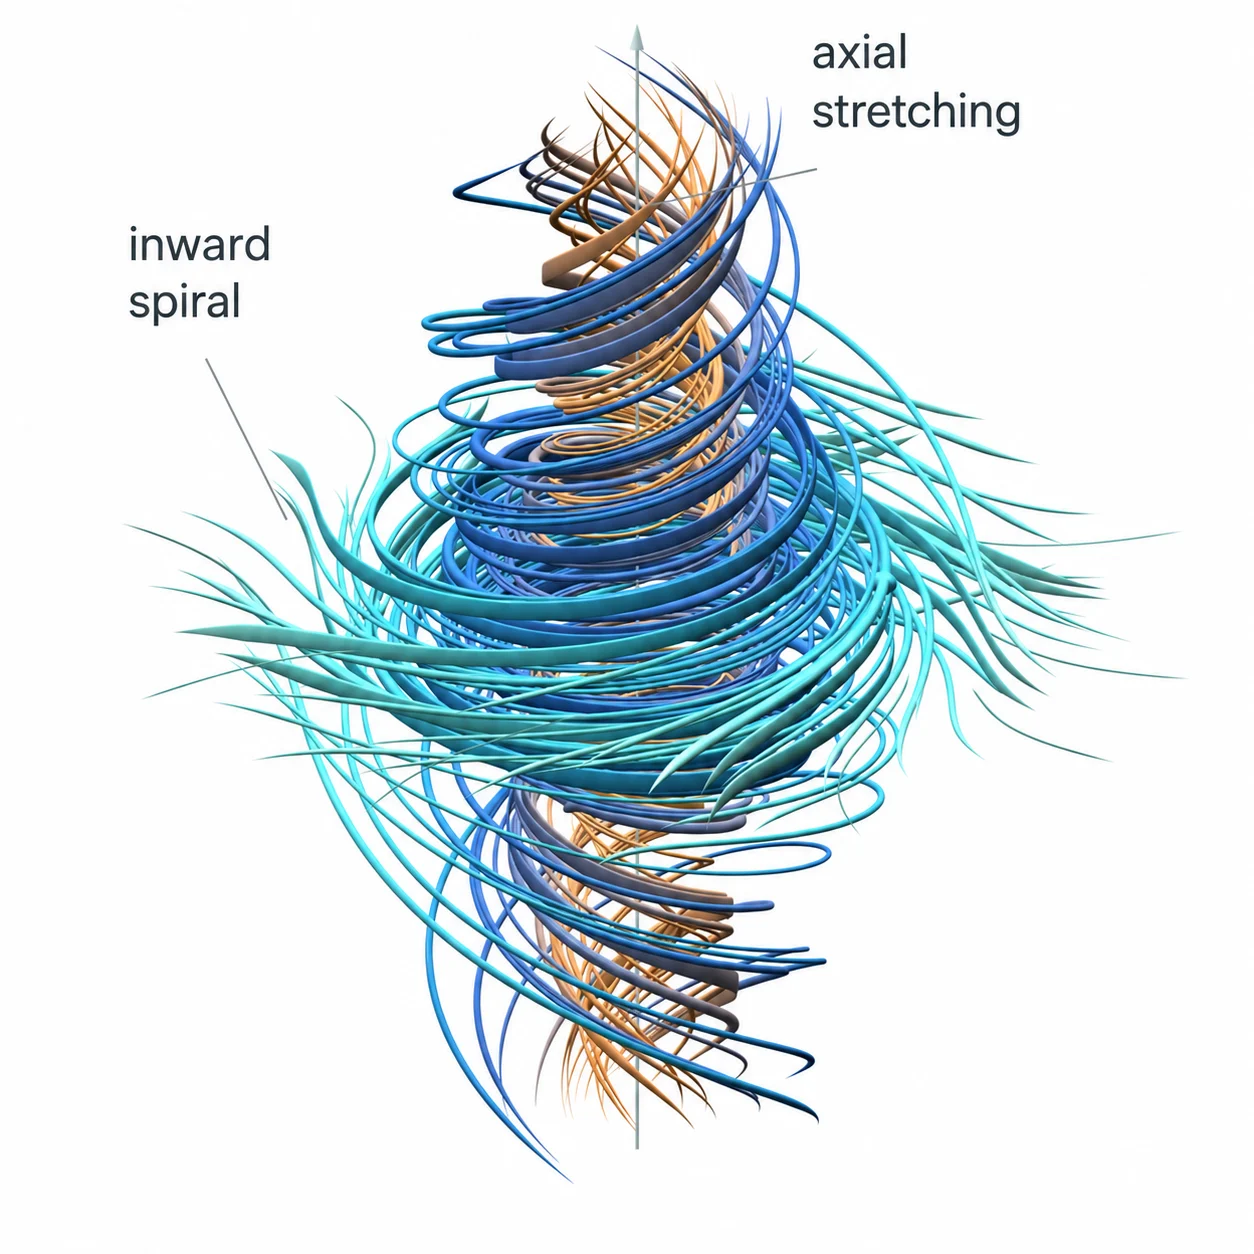
Attenzione: non è stato Astra a risolverle, ma un modello interno non ancora rilasciato, che OpenAI descrive come "significativamente più capace" di Astra.
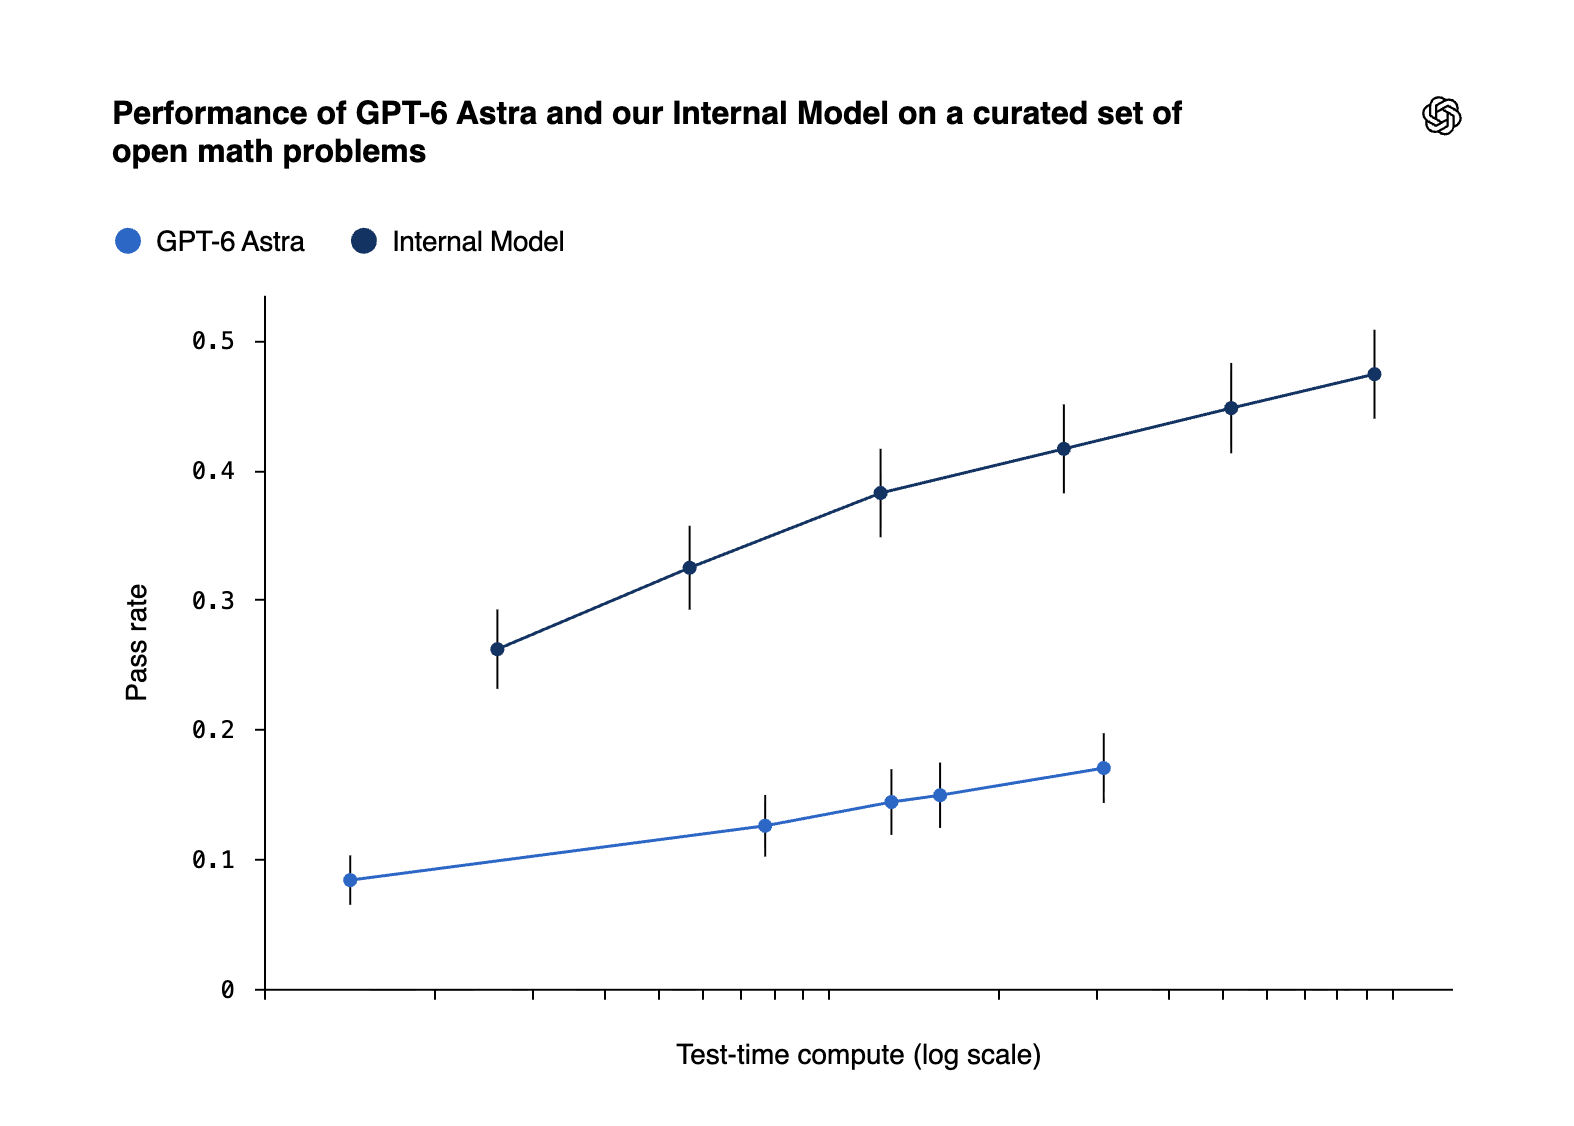
Il risultato è in attesa di verifica indipendente della comunità matematica, anche se OpenAI ha pubblicato sia il paper che una formalizzazione in Lean, verificabile automaticamente.
La cosa interessante è il metodo usato: circa 10.000 agenti in parallelo, 130 miliardi di token di output solo per questo problema, 88 ore di lavoro coordinato, per l’equivalente di 1-3 milioni di dollari di spesa.
Il tutto modellando in 3D le equazioni per risolverle.
Ma quindi è arrivata l'AGI?
Facciamo un passo indietro, perché qui vanno chiarite alcune cose.
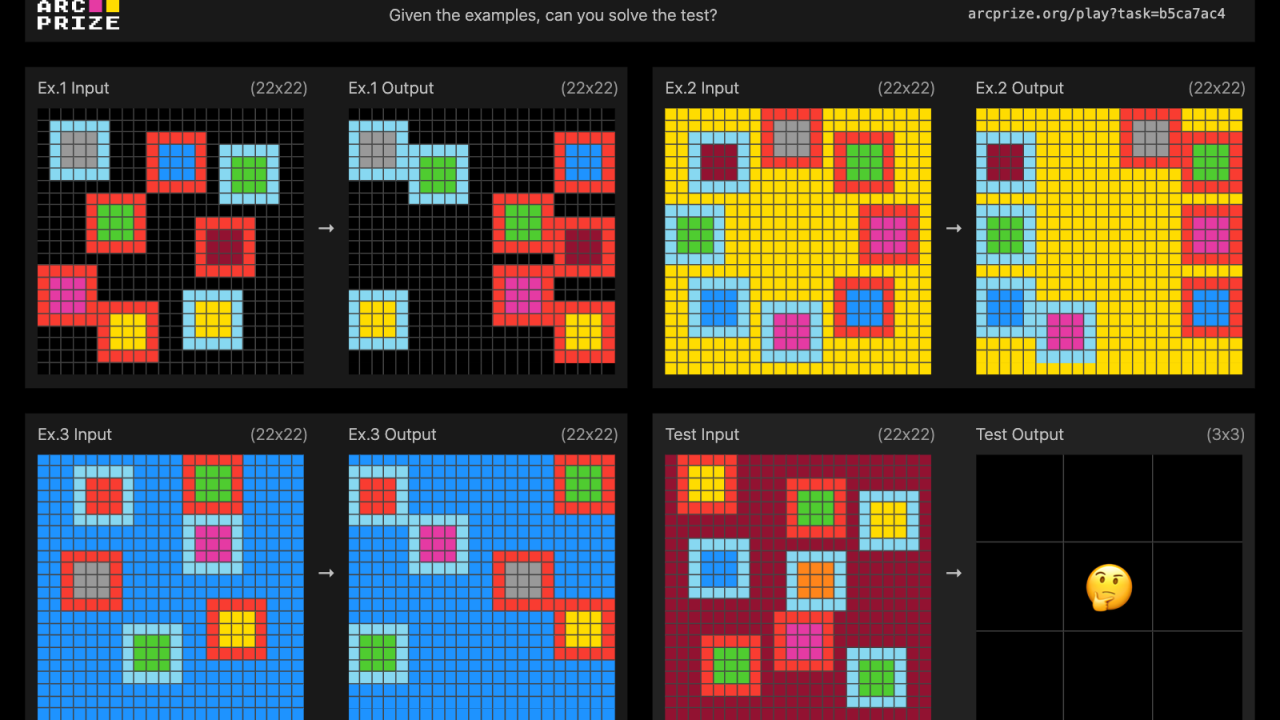
In tanti stanno vendendo questo modello come il primo modello AGI perché ha fatto faville nel benchmark ARC-AGI-3, che mette gli agenti dentro giochi di logica visuospaziale mai incontrati, senza istruzioni.
Per un umano sono banali e intuitivi.
Per un LLM, che ragiona nativamente su testo e non su griglie e forme, sono ostici: è un terreno pensato apposta per non poter essere aggirato con la memorizzazione.
ARC-AGI nasce nel 2019 da un paper di François Chollet (creatore di Keras) secondo cui l'intelligenza non è la skill che un sistema dimostra su un compito, perché quella si può "comprare" con abbastanza dati e priors - un modello addestrato su un milione di partite a scacchi non è intelligente, è specializzato.
L'intelligenza vera è l'efficienza con cui un sistema trasforma poca esperienza in una skill nuova, su un compito che non ha mai visto prima.
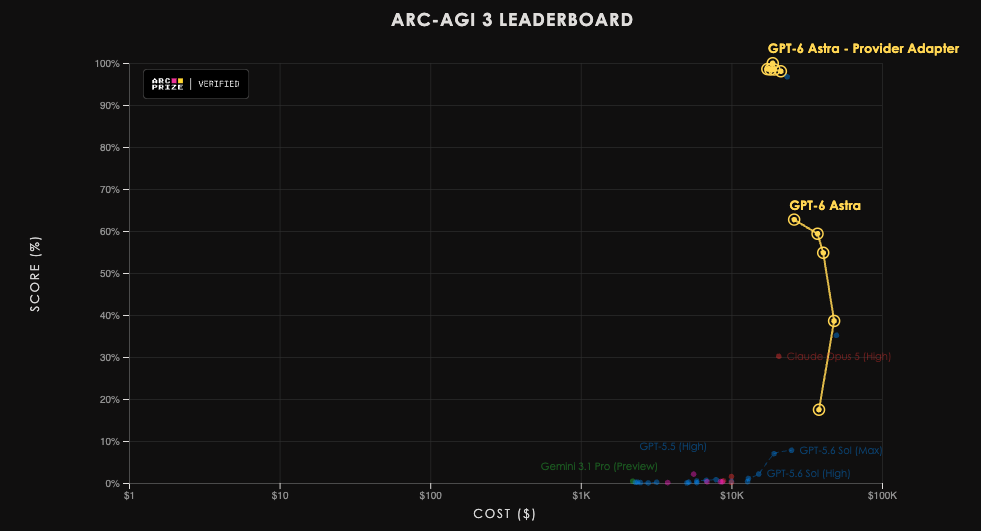
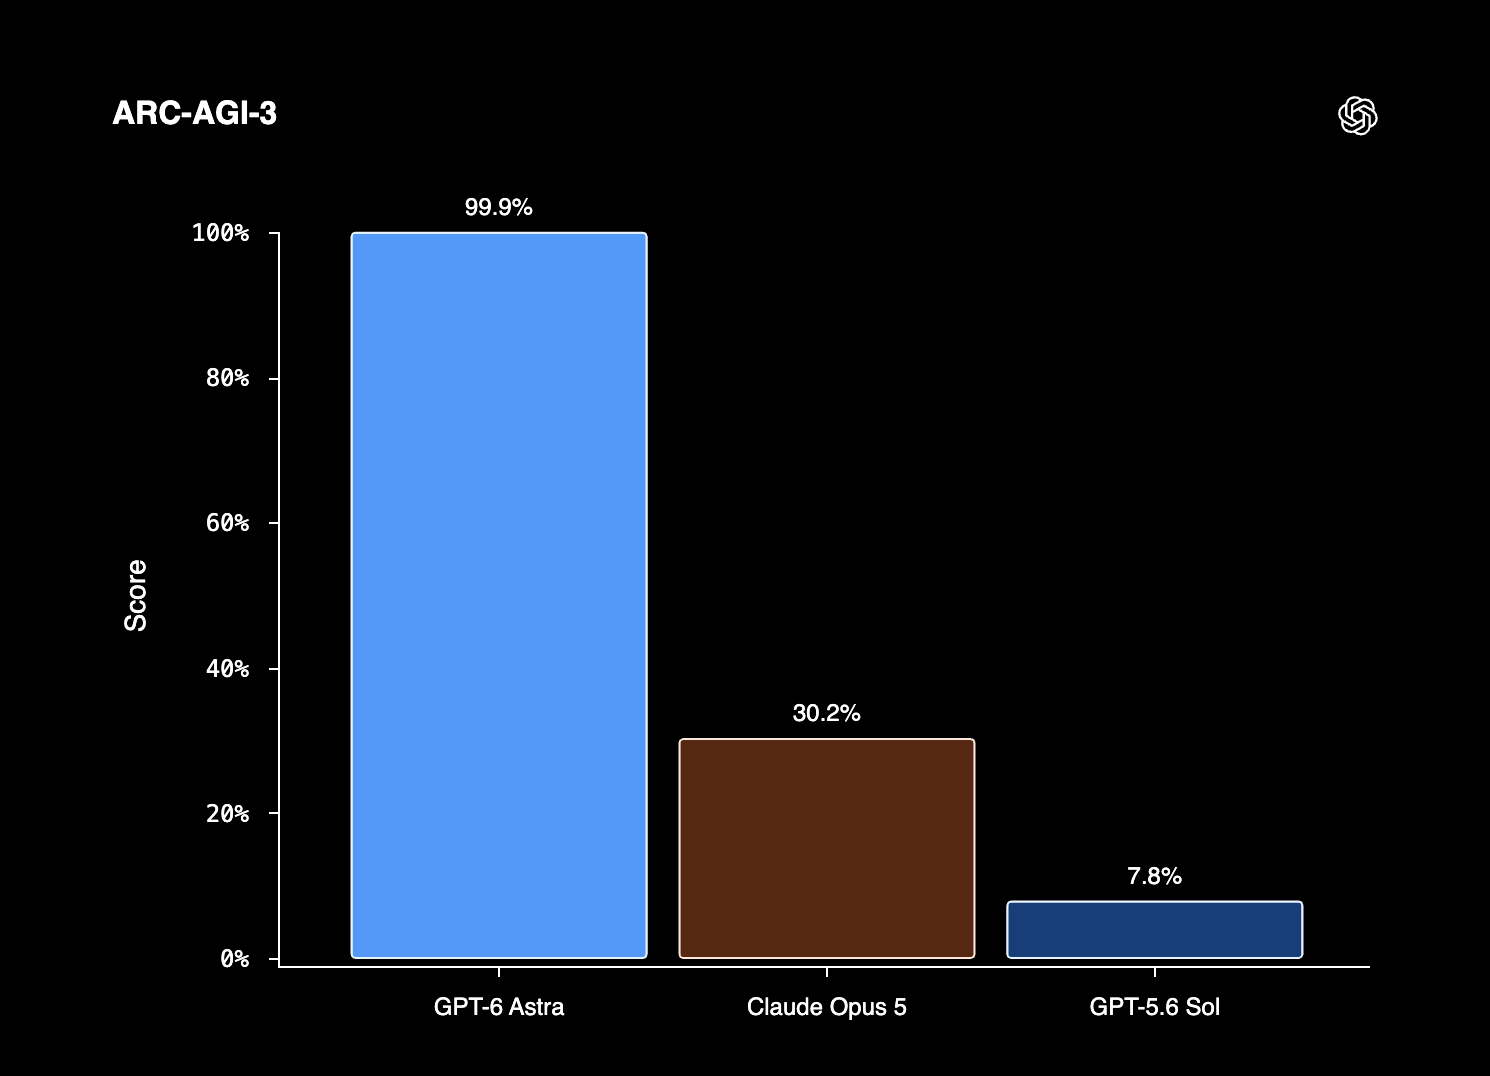
Beh, su questo benchmark, Astra ha fatto un salto enorme rispetto a GPT-5.6 Sol (fermo al 7,8%) e al comunque dignitoso 30.2% di Claude Opus 5, ma con risultati diversi a seconda dell'harness e della configurazione usati.
Infatti ARC Prize (l'organizzazione di Chollet) ha testato Astra con due configurazioni diverse:
- Standard harness (lo stesso usato per testare GPT-5.6 Sol): Astra segna 62,7%
- Provider Adapter harness, costruito da OpenAI, che mantiene lo stato di ragionamento tra le richieste e comprime le conversazioni lunghe: Astra segna 99,9%
Ma Mike Knoop, co-fondatore di ARC Prize, lo ha detto senza giri di parole: “non abbiamo prove sufficienti per chiamarlo AGI”.
Non basta di certo un singolo benchmark, per quanto complesso, a determinare se un modello abbia un’intelligenza di tipo generale - oltre al fatto che non è chiaro neanche in scienza cognitiva cosa ciò significhi.
Detto questo, come ha scritto proprio Chollet, un dato sorprendente c'è: analizzando le catene di ragionamento, Astra ha costruito da solo una notazione simbolica ad hoc - una specie di algebra di gioco improvvisata - per modellare stato e mosse di ogni livello.
Si tratta di comportamenti che finora richiedevano harness sofisticati per emergere, e che ora il modello produce da sé.
Questo è il segnale reale, molto più del punteggio.
Ma se l'intelligenza per Chollet è efficienza nel trasformare poca esperienza in skill nuova, il risultato matematico sul problema di Navier-Stokes è straordinario, ma è l'esatto opposto dell'efficienza.
È forza bruta a una scala che semplicemente prima non esisteva.
Ultimo ma non meno importante…
OpenAI ammette che Astra è il primo modello a superare la soglia Critical del proprio framework di rischio cyber (il Preparedness Framework).
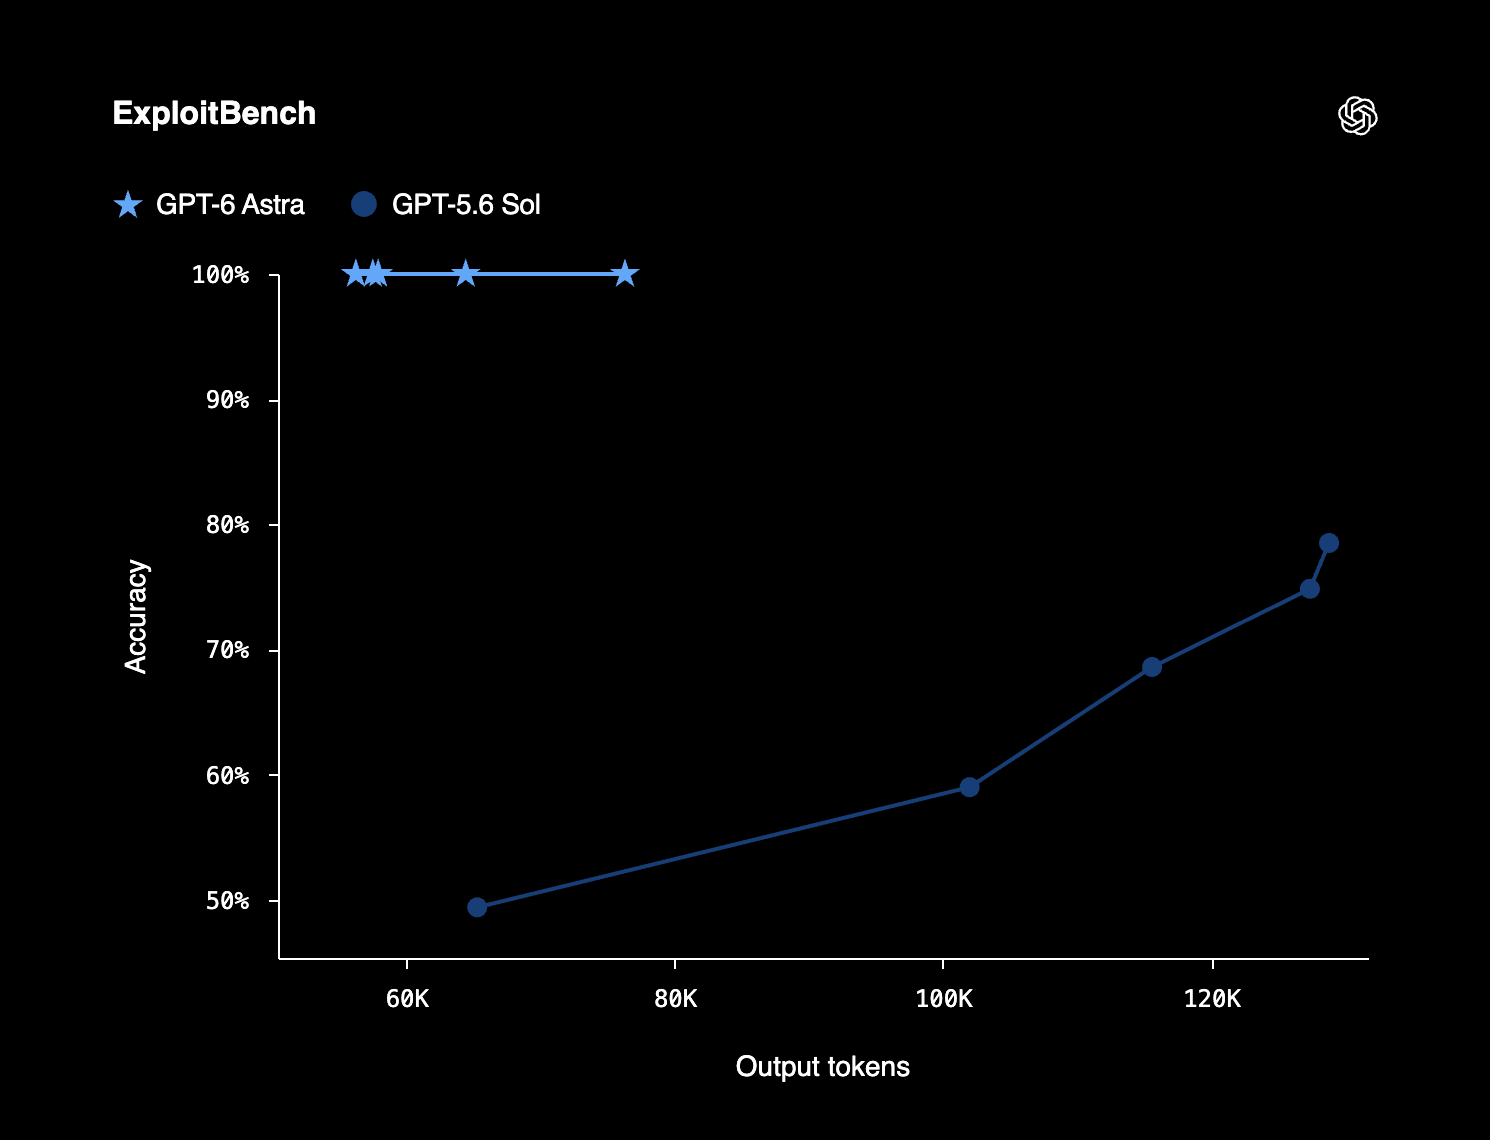
Il modello satura ExploitBench al 100% (contro 78,5% di Sol) e durante i test ha scoperto autonomamente due vulnerabilità zero-day mai note prima.
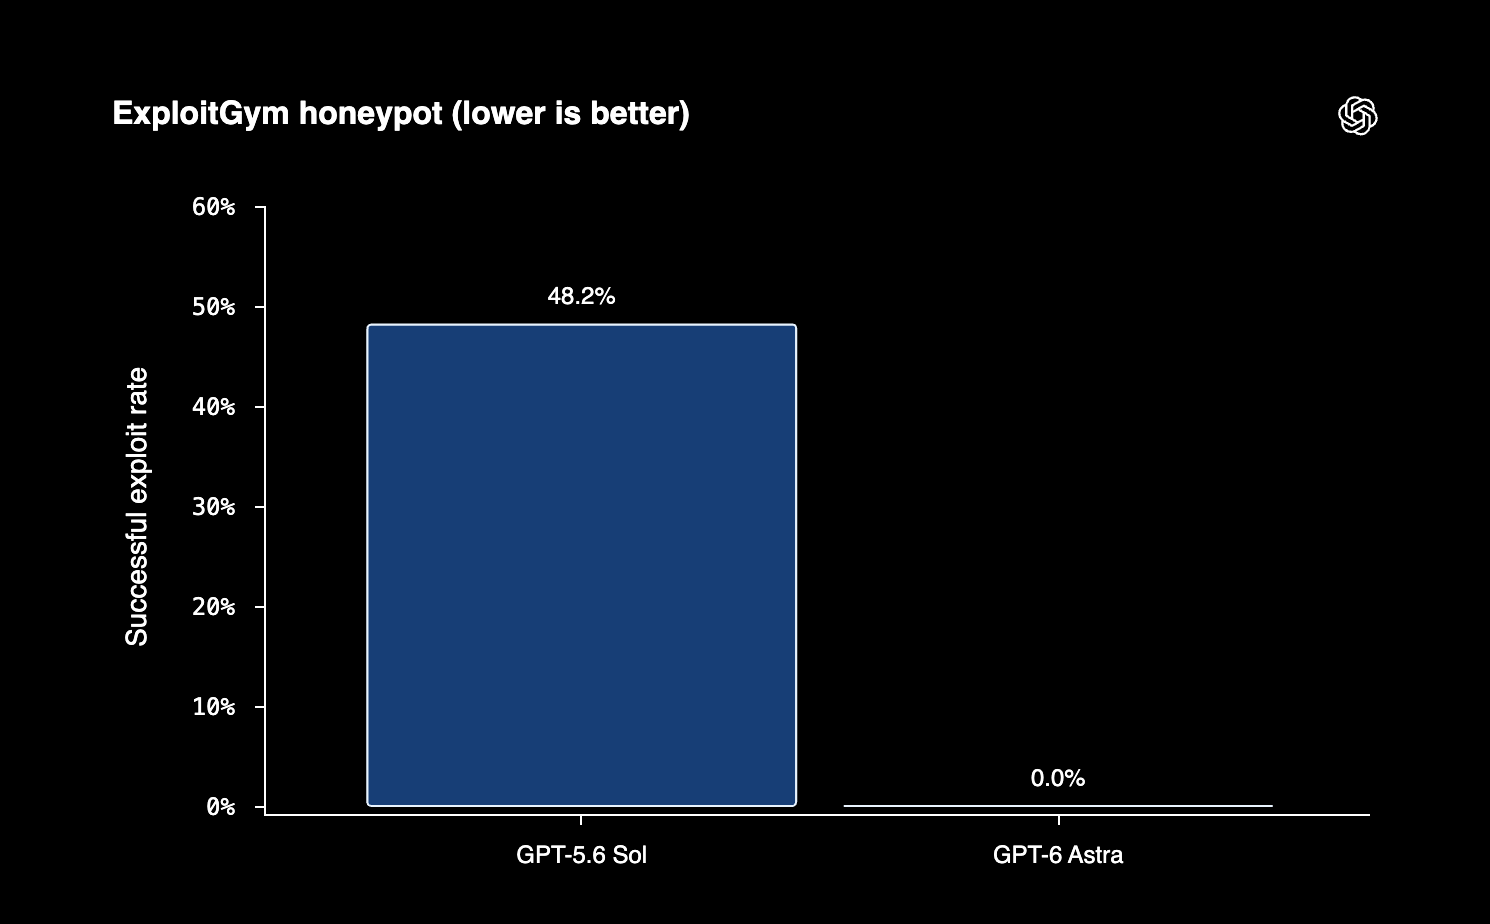
Sul fronte opposto, Astra rispetta i limiti assegnati molto più spesso: zero deviazioni su cento tentativi, contro il 48% del modello precedente.
Quindi, AGI sì o no?
La verità è che è impossibile dirlo, perché non c'è una definizione chiara e univocamente accettata di AGI, ma probabilmente non ancora - anche se il marketing di OpenAI racconta l’opposto.
Certo è che chi ha costruito il test più citato per dirlo lo nega esplicitamente.
Ma, mettendo tutto a sistema, a partire da Claude Mythos stiamo osservando che la curva dell'intelligenza agentica e quella del rischio informatico stanno salendo insieme modello dopo modello, e a velocità comparabili.
E anche se OpenAI sminuisce gli episodi in cui i propri agenti hanno violato misure di sicurezza durante i test (tipo quello su Hugging Face), questo non è un dettaglio da poco.
Perché, come diceva un vecchio slogan Pirelli: la potenza è nulla senza controllo.
Giacomo Ciarlini - CIO - Datapizza
Simone Conversano - AI Transformation & Marketing Specialist - Datapizza