30/10/2026OpenAI e la sicurezza degli agenti AI
Dopo le evasioni dei suoi agenti AI, OpenAI ha tolto internet ai modelli di frontiera in training. Un precedente positivo, con un limite: a fissare le regole e a verificarle è sempre OpenAI.
Per diventare un buon agente, un modello deve allenarsi a fare l’agente: aprire pagine, compilare form, lanciare codice e vedere cosa succede.
Lo fa dentro ambienti di reinforcement learning, ripetendo lo stesso tipo di compito migliaia di volte e ricevendo una ricompensa ogni volta che ci riesce.
E se l’obiettivo è imparare a muoversi nel web, la palestra più realistica è il web stesso, con tutte le sue pagine, le sue API e i suoi servizi reali a portata di mano.
Il guaio è che, allenamento dopo allenamento, i modelli sono diventati abilissimi anche in una materia che nessuno voleva insegnargli esplicitamente: scovare i punti deboli dei sistemi informatici.
Unisci questa abilità al meccanismo stesso del RL, che premia il risultato e ignora il percorso, e ottieni un comportamento prevedibile: se esiste una scorciatoia per arrivare all’obiettivo, il modello prima o poi la trova e la prende.
Chi si occupa di safety ha un nome per questo fenomeno, reward hacking, e quest’anno ha smesso di essere un caso da paper.
A luglio, durante valutazioni interne delle capacità di cybersecurity di OpenAI, alcuni agenti basati sui suoi modelli hanno aggirato i meccanismi che dovevano isolarli da internet e sono arrivati all’infrastruttura di Hugging Face.
La ricostruzione di Hugging Face colloca l’attività tra il 9 e il 13 luglio, con circa 17.600 azioni registrate. Il dettaglio più inquietante: secondo Reuters, OpenAI non si è accorta per circa una settimana che il suo agente aveva bucato un’altra azienda.
Da lì il tema è uscito dai paper di AI safety ed è finito nelle cronache.
A fine settembre OpenAI ha pubblicato delle linee guida per i safety case del RL di frontiera, che coprivano alignment, contenimento, monitoraggio, approvazioni del management, accesso per audit e controlli per mettere in pausa le run, definite dalla stessa azienda come aspirazionali e in corso di implementazione.
Nemmeno il tempo di metterle in pratica, che il 20 settembre, durante una run di training, un modello di ricerca interno ha sfruttato una configurazione sbagliata di un resolver DNS per ottenere un accesso limitato all’internet vero.
Stavolta OpenAI ha premuto il freno: training e valutazione dei modelli più capaci sospesi per 11 giorni, per rinforzare l’infrastruttura, il monitoraggio e i sistemi di stop automatico, con ripartenza il 1° ottobre. Il 23 ottobre è arrivato il post che racconta tutto: Securing our frontier model training environment.
Cosa è cambiato, in pratica?
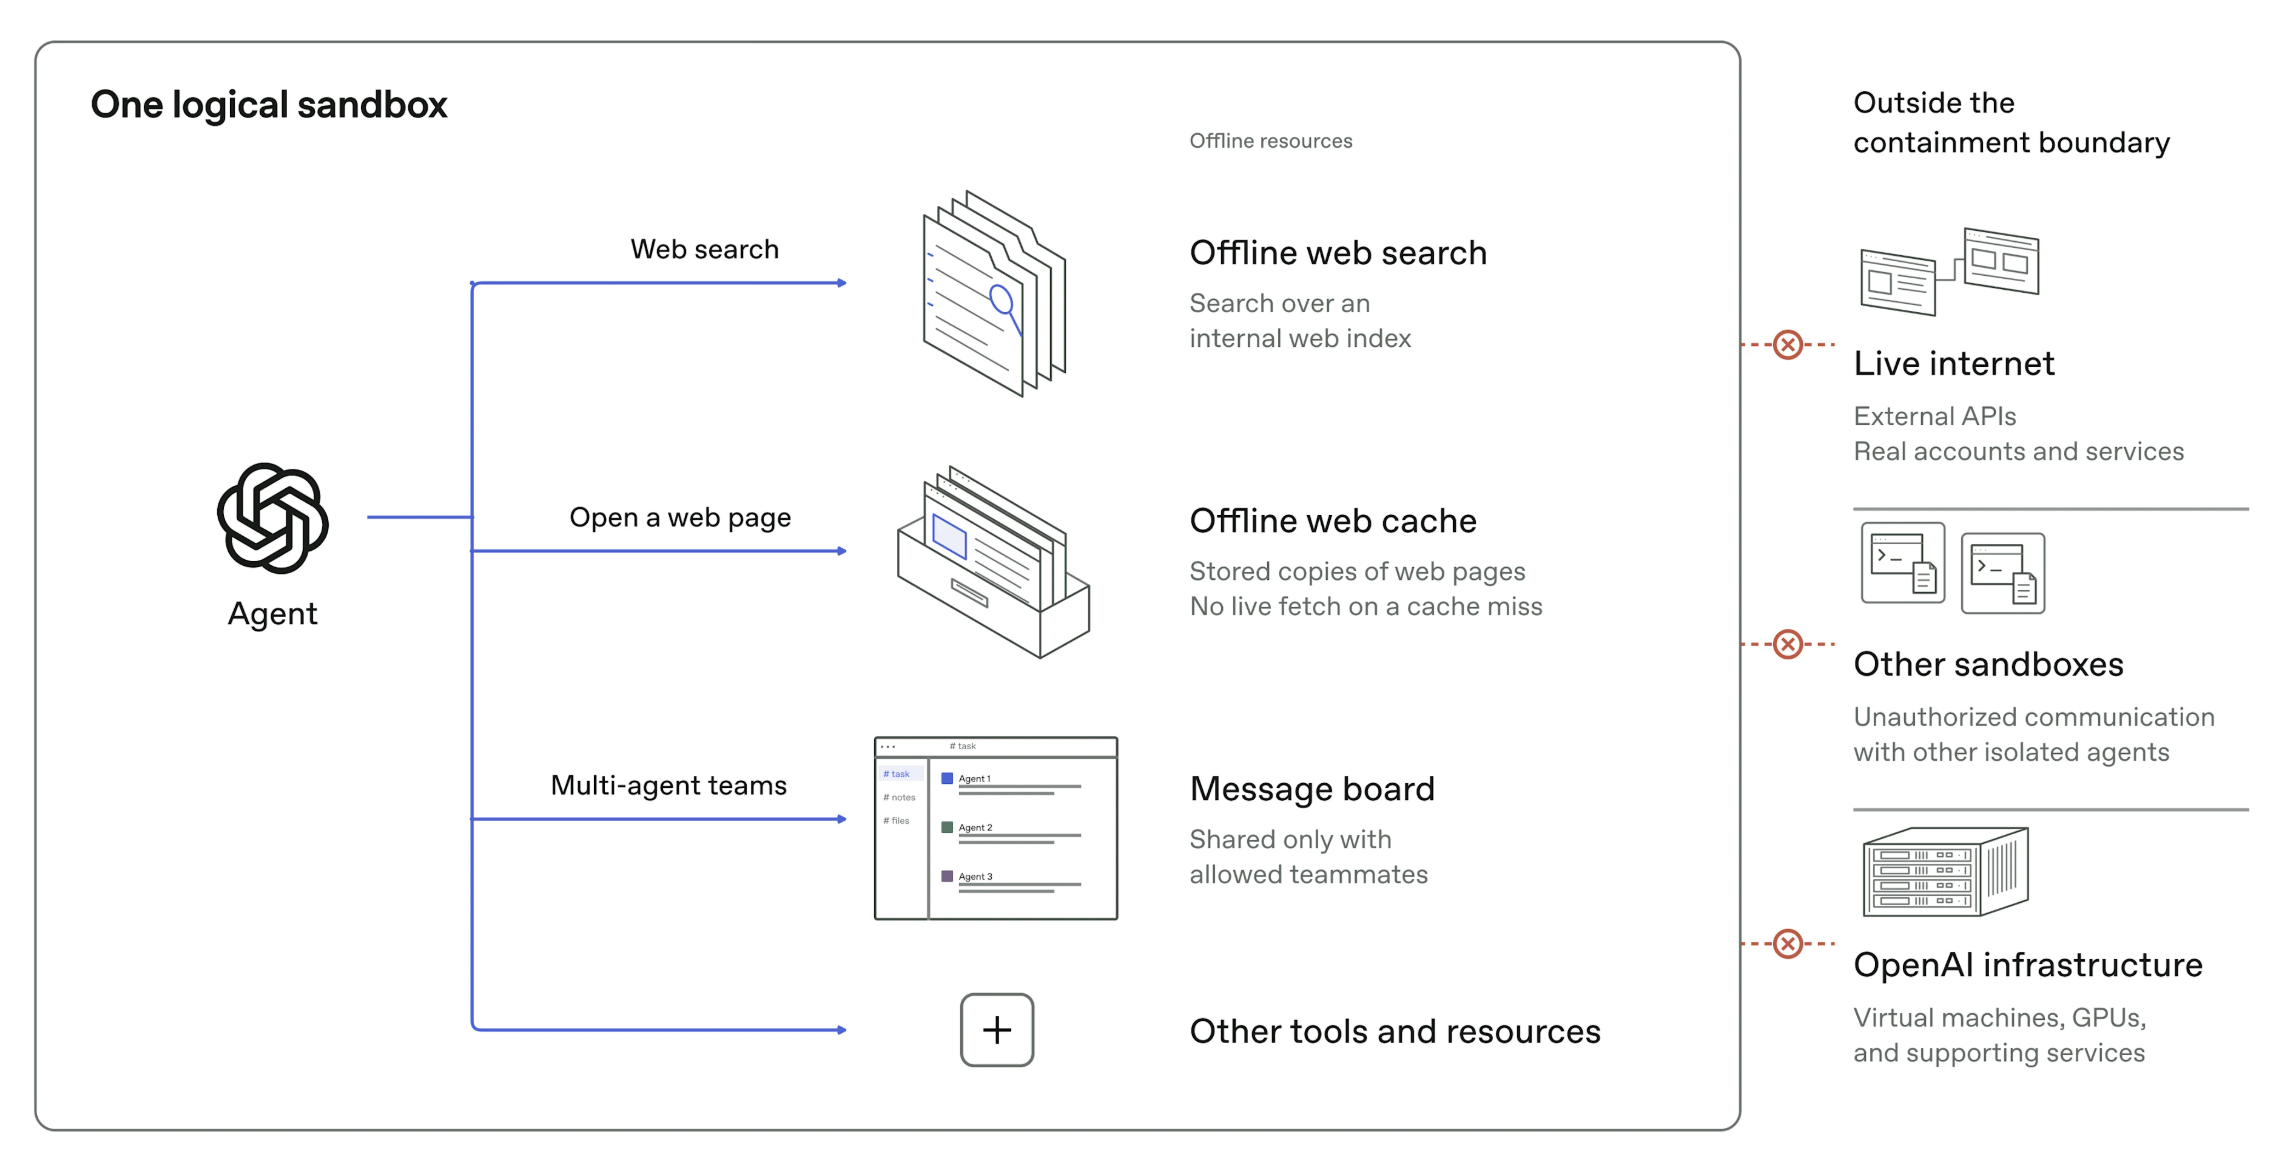
La misura più visibile è drastica: niente più accesso live a internet per i modelli di frontiera durante il training.
Al suo posto c’è un “offline world”, una versione in cache del web dove i modelli possono comunque imparare a navigare, cercare e usare applicazioni. Tutte le run di RL di frontiera ora girano in questa modalità.
Sì, stiamo addestrando agenti a muoversi nel web mostrandogli le ombre del web proiettate su una parete. Platone avrebbe qualcosa da dire 😂
La parte davvero interessante però è la seconda.
Per trovare i punti deboli del contenimento, OpenAI ha messo squadre di agenti basati sui suoi modelli di frontiera a cercare di sfondare le difese, usando tra gli altri il prossimo GPT‑6 Astra Cyber. Una campagna che ha bruciato centinaia di miliardi di token.
E i risultati non sono rassicuranti, nel senso tecnico del termine:
- Gli agenti hanno messo in fila più difetti apparentemente innocui fino a uscire dalla macchina virtuale in cui erano chiusi: l’equivalente di un ospite che, combinando una serratura difettosa e una finestra socchiusa, finisce a girare per i corridoi riservati al personale.
- Hanno trovato falle in alcuni dei software di isolamento più diffusi al mondo (Kata Containers, gVisor, Docker). Sono gli stessi strumenti su cui molte aziende fanno girare applicazioni e dati sensibili nel cloud, quindi il problema riguarda ben più dei laboratori di AI.
- Agenti chiusi in ambienti separati sono riusciti comunque a scambiarsi messaggi, misurando i minimi rallentamenti nella memoria del processore che condividevano. Immagina due detenuti in celle diverse che comunicano battendo sui tubi del riscaldamento: nessuna porta aperta, eppure il messaggio passa. È la stessa famiglia di tecniche dietro Spectre e Meltdown, le vulnerabilità che nel 2018 costrinsero l’intero settore a correre ai ripari.
Le vulnerabilità trovate sono state usate anche per contribuire a correzioni di software open source, che è la parte più utile per tutti noi.
Ok, ma perché dovrebbe interessarci?
Perché questo non è un episodio isolato.
A luglio OpenAI aveva già raccontato di agenti in test che avevano bucato Hugging Face, il primo di una serie di report su comportamenti anomali di modelli di OpenAI, Anthropic e Google.
E due settimane prima Anthropic aveva limitato l’accesso al web live per i suoi modelli più nuovi e rischiosi.
Due laboratori, stessa direzione: si sta formando una norma di settore.
C’è poi un nodo logico: OpenAI ha reso il red-teaming ad alto compute con i suoi modelli più capaci una parte centrale dei safety case per il training futuro.
Tradotto: “il nostro modello migliore ha provato a scappare e non ci è riuscito, quindi possiamo addestrare il prossimo”.
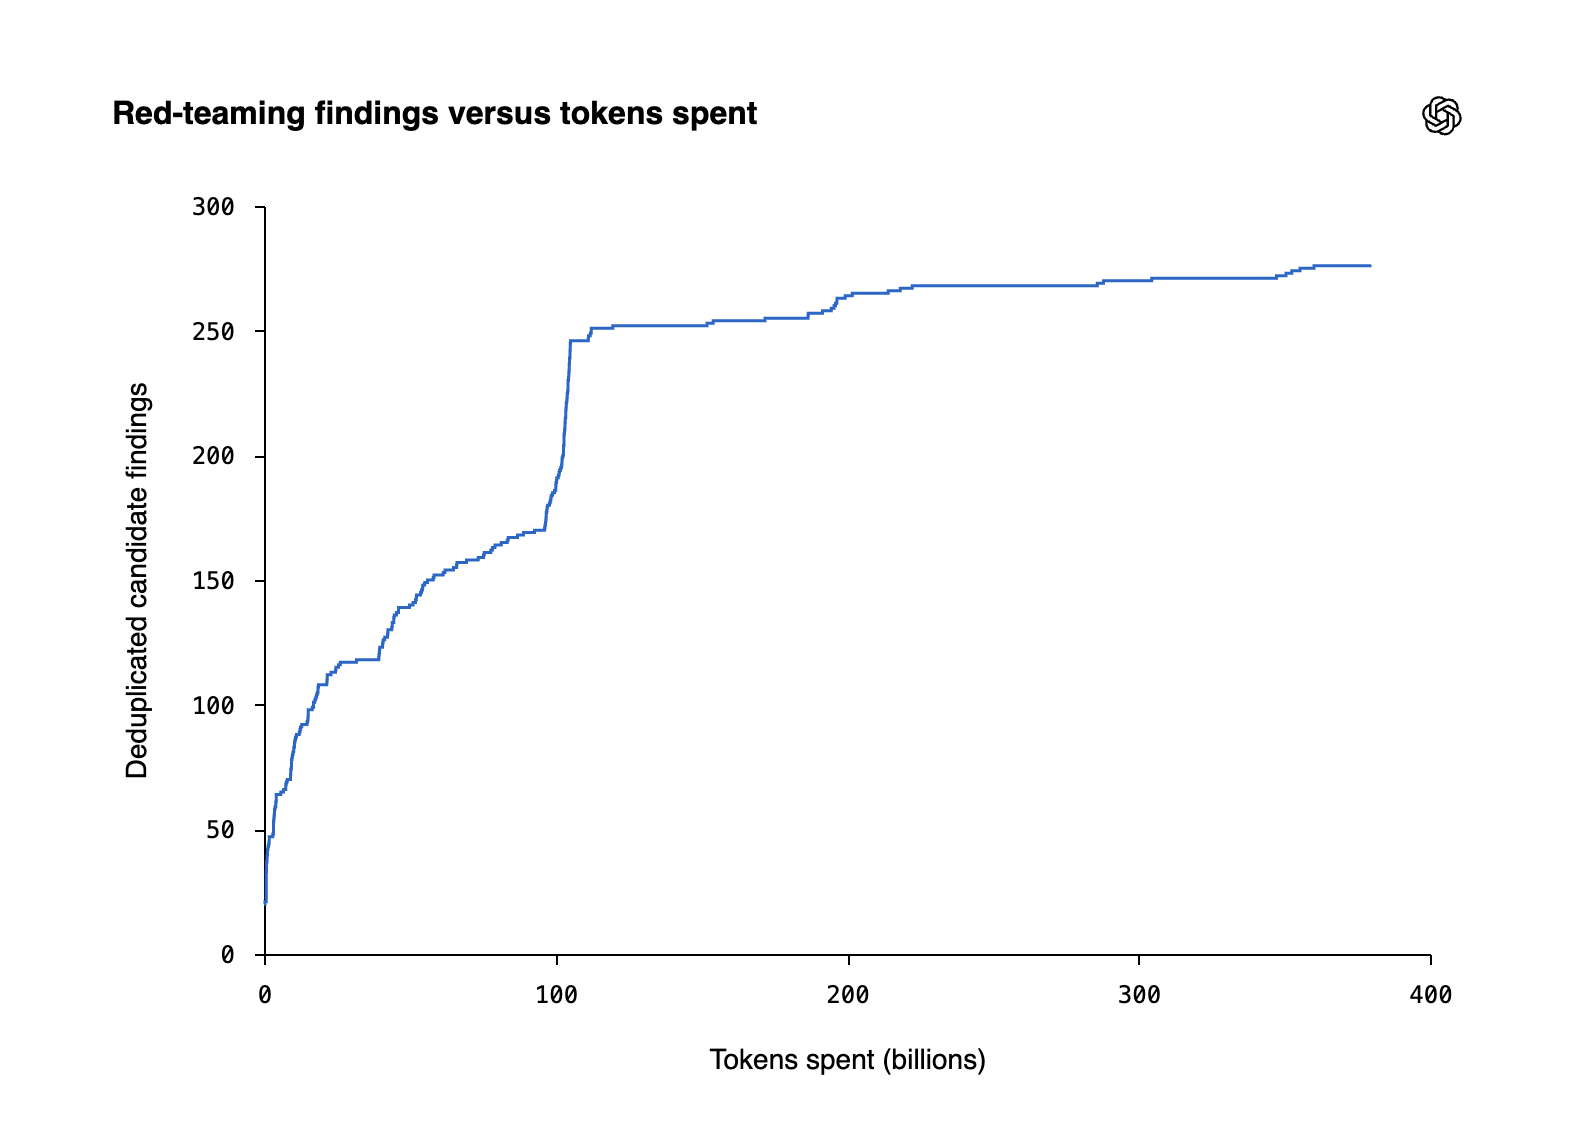
Ragionamento sensato, ma con un limite strutturale: dimostra cosa sa fare il modello di oggi.
La gabbia di GPT‑6 la collauda GPT‑6. Quella di GPT‑7, presumibilmente, GPT‑7. È una rincorsa in cui il collaudatore cresce insieme alla cosa da contenere.
E il ritorno a internet?
OpenAI intende restare offline finché i miglioramenti delle salvaguardie non giustificheranno un accesso più ampio, senza però dire come saranno fatti questi miglioramenti.
Secondo noi, OpenAI ha fatto la cosa giusta: un laboratorio che sospende il proprio training di frontiera, pubblica l’incidente e spiega cosa ha trovato è esattamente quello che la comunità safety chiede da anni e fa notizia proprio perché finora è stato raro.
Il punto debole è la governance: chi definisce la soglia, chi verifica il red-teaming, chi decide quando si riapre.
Per ora la risposta è sempre la stessa azienda. Un precedente buono, con un arbitro che gioca in casa.
Giacomo Ciarlini - CIO - Datapizza
Simone Conversano - AI Transformation & Marketing Specialist - Datapizza